เครื่องเดียว 2 vCPU / 4 GB ปีละ 28.80 ดอลลาร์
ทำไมเลือก ทำไมพอ และพอถึงตรงไหน
Petcare Assistant เป็นผู้ช่วย AI และ CRM บน LINE สำหรับร้านสัตว์เลี้ยง ระบบเป็น multi-tenant คือหลายร้านใช้ฐานข้อมูลเดียวกัน ผมทำคนเดียว และมีเดโมเปิดให้ลองที่ https://petcare.rattanun.dev ทั้งระบบของเดโมรันอยู่บนเครื่องเดียว คือ Tencent Cloud Lighthouse ที่กรุงเทพฯ ขนาด 2 vCPU, RAM 4 GB, SSD 60 GB
บทความนี้ตอบสามคำถามที่ผมโดนถามบ่อย ทำไมเลือกเครื่องนี้ ทำไมเชื่อว่าเครื่องเล็กแค่นี้พอ (และพอถึงตรงไหน) และทำอะไรไว้บ้างให้ระบบอยู่ในเครื่องขนาดนี้ได้ ตัวเลขทุกตัวมาจากบันทึกใน repo ข้อไหนยังไม่ได้วัด ผมบอกไว้ตรงนั้นเลย เรื่องการ deploy อัตโนมัติอยู่ในบทความ CI/CD ส่วนวิธีทำ load test อยู่ในบทความ load test ที่นี่จะหยิบมาแค่ตัวเลขที่ใช้ตัดสินขนาดเครื่อง
ทำไมเป็น Tencent Cloud Lighthouse ที่กรุงเทพฯ
Lighthouse เป็น VPS แบบง่าย คล้าย Lightsail ของ AWS ได้เครื่อง Linux หนึ่งตัว ดิสก์ firewall และ traffic เป็นแพ็กเกจเดียว ขนาดที่ผมซื้อมี 2 vCPU, RAM 4 GB, SSD 60 GB, bandwidth 30 Mbps และ traffic 1,536 GB ต่อเดือน ผมได้ราคาลูกค้าใหม่ 28.80 ดอลลาร์สำหรับปีแรก ราคาปกติคือเดือนละ 6 ดอลลาร์ ถ้าต่อปีที่สองก็ 72 ดอลลาร์ ผมปิด auto renew ไว้ จะได้ตัดสินใจเองตอนครบปี ไม่ใช่โดนตัดบัตรราคาเต็มอัตโนมัติ
เหตุผลที่เลือกมีสี่ข้อ
- ราคา เดโมนี้มีร้านตัวอย่างร้านเดียว ถ้าใช้ managed service (คอนเทนเนอร์, Postgres, Redis แบบมีคนดูแลให้) ค่าใช้จ่ายจะสูงขึ้นราวสิบเท่า แผนแรกของผมคือ AWS และยังเก็บไว้ใช้เป็นที่เรียนแบบสร้างแล้วลบ แต่ค่ารันเครื่องตลอดเวลาบน AWS ราวเดือนละ 20–25 ดอลลาร์ไม่คุ้มกับเดโม ส่วนเครดิตลูกค้าใหม่ของ Google Cloud ผมใช้ไปหมดแล้ว
- อยู่ใกล้ผู้ใช้ ลูกค้าของร้านทักมาทาง LINE จากในประเทศ region กรุงเทพฯ จึงอยู่ใกล้ที่สุด และข้อมูลอยู่ในประเทศไทย
- ไม่ผูกกับผู้ให้บริการ สิ่งที่อยู่เหนือเครื่องคือ Docker Compose, Caddy, image ของแอป และ
backup.shซึ่งรันบนเครื่อง Linux ที่มี Docker ได้ทุกเครื่อง ถ้าวันหนึ่งย้ายไปที่อื่น ต้องเปลี่ยนแค่ส่วนที่สร้างเครื่อง ไม่ต้องแก้แอป - 4 GB ไม่ใช่ 2 GB ตอนนั้นมีแพ็กเกจ 2 GB ราคาปีละ 10 ดอลลาร์ด้วย ตัวเลขที่วัดได้บอกว่า stack ใช้ไม่ถึง 1 GB ตอนไม่มี reranker แต่ถ้าเปิด reranker จะเป็น 1.76 GB และผมอยากเหลือที่ไว้ให้โปรเจกต์ที่สองบนเครื่องเดียวกัน ส่วนต่างคือจ่ายเพิ่มราวปีละ 19 ดอลลาร์สำหรับที่ว่างที่วันแรกยังไม่ได้ใช้
ข้อเสียที่ยอมรับไว้มีสามข้อ ข้อแรก มันเป็นเครื่องเดียว ถ้าเครื่องหรือผู้ให้บริการมีปัญหา เดโมจะล่มจนกว่าจะกู้จาก backup ซึ่งรับได้สำหรับเดโม แต่ไม่ใช่สำหรับร้านที่จ่ายเงินหลายร้าน ข้อสอง Lighthouse ไม่มี VPC หรือ IAM role ให้เรียนเหมือน cloud ใหญ่ ข้อสาม ผู้ให้บริการเป็นบริษัทจีน ตอนนี้ในระบบมีแค่ข้อมูลสมมติ ก่อนรับข้อมูลของร้านจริงต้องเช็กเรื่อง PDPA ก่อน
บนเครื่องมีอะไรรันอยู่
ทุกอย่างอยู่ใน compose.prod.yml ไฟล์เดียว
- Caddy ทำ HTTPS และ reverse proxy เป็น service เดียวที่เปิดพอร์ตออกนอกเครื่อง (80, 443 และ 443/UDP สำหรับ HTTP/3)
- web (Next.js) คือ dashboard กับหน้า LIFF รับ webhook จาก LINE แล้วส่งต่อให้ api
- api (NestJS) ตรวจลายเซ็นของ LINE เก็บ event ลงฐานข้อมูลแล้วตอบ 200 ทันที
- worker มาจาก package เดียวกับ api แต่รันเป็น process แยก มีคิว BullMQ ของบอท และ poller อีกสิบกว่าตัว
- Postgres (pgvector) กับ Redis อยู่บนเครื่องเดียวกัน ไม่เปิดพอร์ต มีแค่ container ใน network เดียวกันที่ต่อได้
- migrate กับ backup เป็นงานที่รันครั้งเดียวแล้วจบ อยู่หลัง profile
toolsจึงไม่ได้กิน memory ตลอดเวลา - reranker (Python) ปิดไว้ด้วย profile ของตัวเอง เหตุผลอยู่ในหัวข้อถัดไป
ทำไมเป็น Docker Compose ไม่ใช่ Kubernetes หรือ PaaS image กับไฟล์ compose ชุดเดียวกันรันได้ทั้งบนโน้ตบุ๊กและบนเซิร์ฟเวอร์ deploy ด้วยคำสั่งเดียว และไม่มีอะไรให้เรียนเกินกว่าที่เดโมต้องใช้ PaaS อย่าง Vercel กับ managed database รัน worker ที่ต้องเปิดค้างไว้ตลอดพร้อม poller ในราคาถูกไม่ได้ ส่วน Kubernetes แก้ปัญหาที่เครื่องเดียวไม่มี ราคาที่จ่ายคือ deploy แต่ละครั้งต้องรีสตาร์ต container ทำให้เว็บสะดุดไม่กี่วินาที
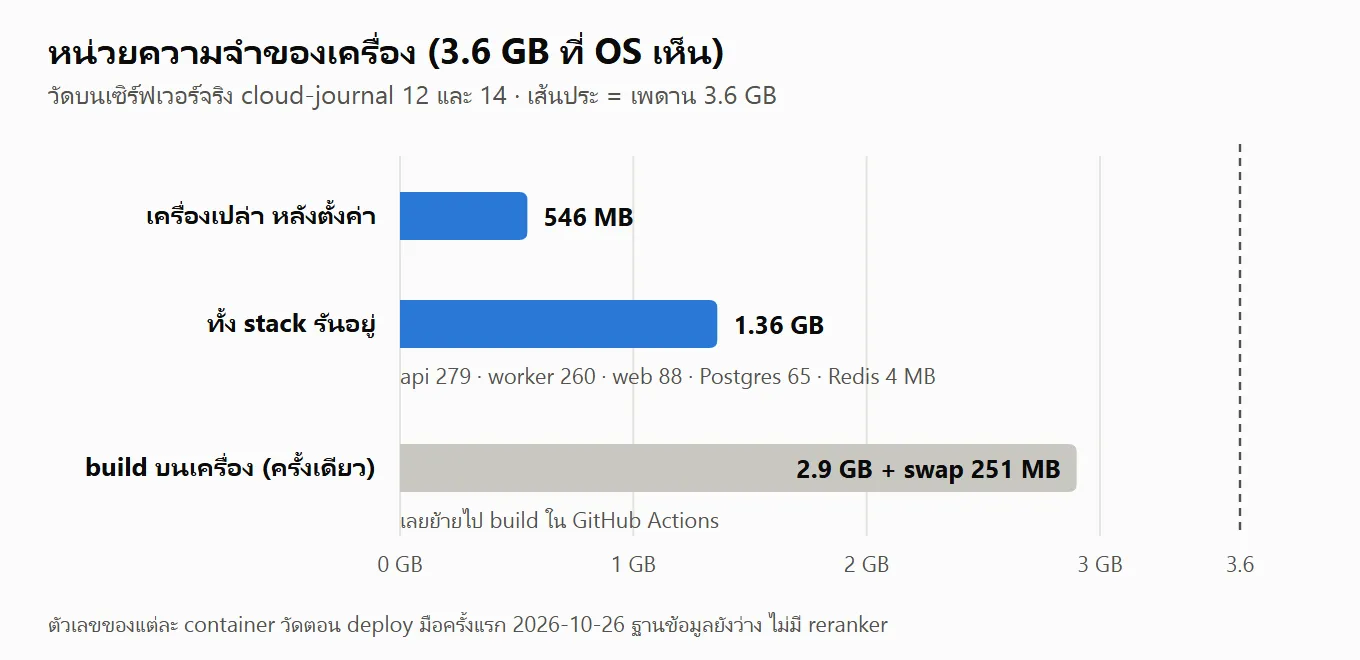
หลักฐานว่าพอ
Memory: วัดบนเครื่องจริง
หลังตั้งค่าเครื่องเสร็จ (SSH, firewall, Docker) เครื่องเปล่าใช้ RAM 546 MB จาก 3.6 GB ที่ OS เห็น ตอน deploy มือครั้งแรกเมื่อ 26 ตุลาคม ทั้ง stack ใช้ 1.36 GB แยกเป็น api 279 MB, worker 260 MB, web 88 MB, Postgres 65 MB และ Redis 4 MB ต้องบอกไว้ด้วยว่าตอนนั้นฐานข้อมูลยังว่าง Postgres จะโตขึ้นตามข้อมูลและ page cache ของมัน ใน docs/deploy.md ผมจึงเขียนไว้ว่า Postgres เป็น service เดียวที่ควรให้ที่ ไม่ควรจำกัด
ตัวเลขชุดที่สองมาจากการวัดบนโน้ตบุ๊ก (2026-10-03) ตอนยิง webhook ที่เซ็นแล้ว 8 ตัวพร้อมกัน peak ของทั้ง stack ที่ไม่มี reranker อยู่ที่ 846 MB ถ้าเปิด reranker ด้วยจะเป็น 1.76 GB สิ่งที่ได้เรียนจากการวัดครั้งนั้นคือ api กับ worker กิน memory สูงสุดตอน boot ระหว่างที่ tsx compile TypeScript แล้วค่อยลดลงเหลือราวหนึ่งในสาม ช่วงที่หนักที่สุดของเครื่องจึงเป็นตอน deploy ที่สอง service รีสตาร์ตพร้อมกัน ไม่ใช่ชั่วโมงที่ลูกค้าทักเยอะ
ตัวเลขที่ใกล้ 4 GB จริงๆ มีตัวเดียว คือการ build image บนเครื่อง ผมทำครั้งเดียวตอน deploy มือ ใช้ 3 นาที 44 วินาที memory ขึ้นไปถึง 2.9 GB และใช้ swap อีก 251 MB ทั้งที่ไม่มีอะไรรันอยู่เลย ตัวเลขนี้เป็นเหตุผลที่เครื่องไม่ build อะไรอีก (เล่าต่อในหัวข้อหลัง)
CPU: ตัวเลขจาก load test ที่บีบเครื่องให้เล็ก
load test รอบแรกรันบนโน้ตบุ๊ก แต่ผม pin ทุก container ไว้ที่สอง core และตั้ง memory limit รวมราว 1.9 GB ซึ่งเล็กกว่าเครื่องเดโม ผลที่ใช้ตัดสินขนาดเครื่องมีสองชุด
- webhook (S1) ที่ 100 ข้อความต่อวินาที ไม่มี error เลย p95 อยู่ที่ 10.7 ms ตอนนั้น api ใช้ CPU ราว 25–30% ของหนึ่ง core เมื่อดันต่อไปจนกราฟหักโค้ง throughput แบนอยู่ที่ราว 390 ข้อความต่อวินาที และยังไม่มี error
- บอทตอบแชท (S2) ใช้โมเดลปลอมที่หน่วง 2 วินาทีให้ช้าเท่าของจริง ที่ 1 แชทใหม่ต่อวินาที ลูกค้ารอคำตอบ p50 4.8 วินาที ในนั้นมี 2.5 วินาทีที่ระบบตั้งใจรอให้ลูกค้าพิมพ์จบก่อน
ร้านสัตว์เลี้ยงที่ยุ่งมากได้ข้อความแค่ไม่กี่ข้อความต่อนาที ถ้าคิดคร่าวๆ ฝั่งบอทยังรับได้มากกว่านั้นหลายสิบเท่า และฝั่ง webhook หลายพันเท่า
Disk
หลังตั้งค่าเครื่อง ดิสก์ใช้ไป 7.2 GB จาก 59 GB image ที่ใหญ่ที่สุดคือ petcare-app (api, worker และ migrate ใช้ร่วมกัน) ขนาด 1.84 GB ส่วน petcare-web 356 MB เมื่อ 4 พฤศจิกายนดิสก์ใช้อยู่ 19 GB พอลบ build cache ที่เหลือจากการ build บนเครื่องครั้งนั้น (3.6 GB) ก็ลดเหลือ 16 GB หรือ 28% backup แต่ละครั้งมีขนาดราว 0.3 MB เพราะยังเป็นข้อมูลของร้านตัวอย่าง
Traffic จริงของเดโม
ข้อนี้ต้องพูดตรงๆ ว่าน้อยมาก ตั้งแต่ต่อ LINE เมื่อ 28 ตุลาคมจนถึงวันที่ผมล้างแชททั้งหมดเมื่อ 2 พฤศจิกายน มีทั้งหมด 8 บทสนทนา, 56 ข้อความ และ 20 inbound event จากลูกค้าที่ไม่ใช่ข้อมูล seed 8 คน หลังจากนั้นผมยังไม่ได้นับ เดโมนี้จึงยังไม่เคยเจอโหลดจริงที่ใกล้ตัวเลขใน load test เลย หลักฐานว่าพอจึงมาจาก load test กับ memory ที่วัดได้ ไม่ได้มาจากการที่เครื่องรอดผ่านช่วงคนใช้เยอะมาแล้ว
เวลาตอบจริงบนเซิร์ฟเวอร์กับโมเดลจริง (gemini-2.5-flash) อยู่ที่ 3.4–5.0 วินาทีต่อ turn เมื่อลองจาก terminal และ 1.3–3.2 วินาทีสำหรับข้อความจากโทรศัพท์ ยกเว้นหนึ่งข้อความที่โมเดล timeout แล้วลองใหม่จนใช้เวลา 22 วินาที ค่าโมเดลตกราว 0.001–0.002 ดอลลาร์ต่อ turn
พอถึงตรงไหน: อะไรจะตันก่อน
“พอ” มีขอบเขตของมัน สรุปไว้ก่อนในตาราง แล้วค่อยเล่าทีละข้อ เรียงจากสิ่งที่น่าจะเจอก่อนไปหลัง
| อะไรตัน | ตันที่ไหน | วัดจาก |
|---|---|---|
| คิวของบอท | ราว 2 แชทใหม่ต่อวินาที (โมเดลปลอม 2 วินาที) | load test S2 บนโน้ตบุ๊ก 2 core |
| ผู้ให้บริการโมเดล | 429 แม้แต่ข้อความเดียว ถ้าโควตาร่วมเต็ม | production, 2026-11-05 |
| thread เดียวของ api | ราว 390 webhook ต่อวินาที | load test S1 บนโน้ตบุ๊ก 2 core |
| RAM | เมื่อเปิด reranker หรือ build บนเครื่อง | วัดบนเครื่องจริงและโน้ตบุ๊ก |
| ดิสก์ของ Postgres | ยังไม่รู้ | ยังไม่ได้วัดบนเครื่องจริง |
1. คิวของบอท ไม่ใช่ CPU worker ตอบพร้อมกันได้ 5 turn (RESPOND_CONCURRENCY = 5) และ turn หนึ่งใช้เวลาราว 2.5 วินาทีใน load test เพดานจึงอยู่ราว 2 แชทใหม่ต่อวินาที ผลวัดตรงกับที่คำนวณไว้ ที่ 2 แชท/วินาที p95 ขึ้นเป็น 8.5 วินาที และที่ 3 แชท/วินาที p50 กลายเป็น 13.5 วินาทีเพราะคิวยาวขึ้น แต่ตอนนั้น worker ใช้ CPU แค่ราว 7–15% มันไม่ได้ทำงานหนัก แค่รอโมเดลอยู่
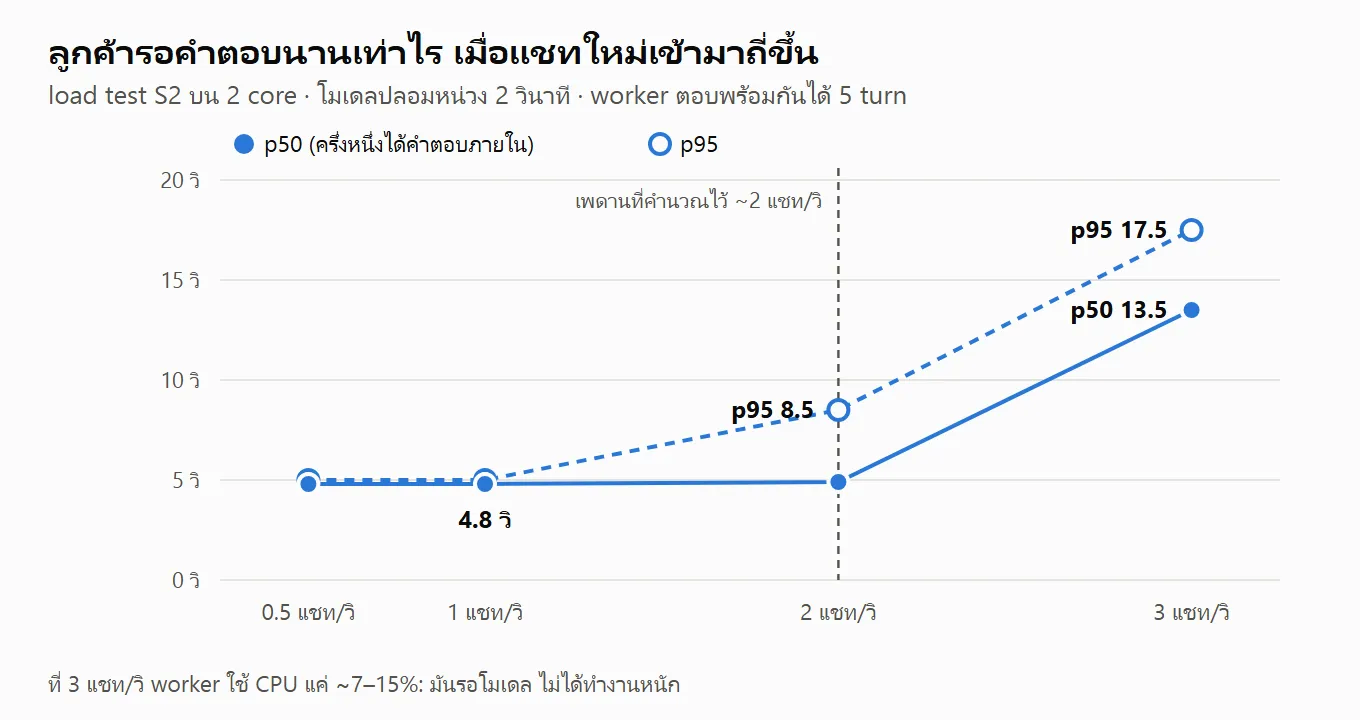
บนเซิร์ฟเวอร์จริง turn กับโมเดลจริงที่บันทึกไว้ใช้ 1.3–5.0 วินาที ถ้า turn ยาวถึง 5 วินาที สูตรเดียวกันให้เพดานราว 1 แชทใหม่ต่อวินาที ตัวเลขนี้ผมคำนวณ ไม่ได้วัด แต่ก็ยังมากกว่าไม่กี่ข้อความต่อนาทีของร้านที่ยุ่งไปไกล
2. ผู้ให้บริการโมเดล สิ่งที่พังจริงบน production ไม่ใช่เครื่อง เมื่อ 5 พฤศจิกายน ข้อความเดียวของลูกค้าโดน HTTP 429 จาก google/gemini-2.5-flash เพราะโควตา Google ที่ OpenRouter ใช้ร่วมกับคนอื่น ตอนนั้นโมเดลสำรองก็เป็นตัวเดียวกัน ลูกค้าจึงได้ข้อความ “ระบบขัดข้อง” แล้วแชทถูกส่งต่อให้พนักงานตามที่ออกแบบไว้ ตอนนี้โมเดลสำรองเป็น anthropic/claude-haiku-5.5 ซึ่งมาจากผู้ให้บริการอื่น การเพิ่ม concurrency ของ worker ก็ช่วยได้แค่ถึง rate limit ของผู้ให้บริการโมเดลเหมือนกัน
3. thread เดียวของ api ที่ราว 390 webhook ต่อวินาที container ของ api ใช้ CPU 97–100% ขณะที่ Postgres ใช้แค่ราว 35% และ web ราว 45% เพราะ Node.js รัน JavaScript บน thread เดียว process หนึ่งจึงใช้ได้อย่างมากหนึ่ง core เรื่องนี้เล่าละเอียดในบทความ load test แต่ตัวเลขนี้ห่างจากงานของร้านจริงมาก
4. Memory ถ้าเปิดของที่ปิดไว้ reranker ใช้ memory ราว 900 MB ด้วยตัวเองและไม่เคยลดลง image ของมันใหญ่ 4 GB และเครื่องนี้ไม่มี GPU รุ่น bge-reranker-v2-m3 ที่จัดอันดับภาษาไทยได้ดีกว่าใช้ 3.4–5 วินาทีต่อ 20 เอกสารบน CPU ขณะที่งบเวลาคือ 800 ms ทุก call จึงจะ timeout ถ้าเปิด stack ทั้งหมดจะขึ้นไปราว 1.76 GB ซึ่งยังอยู่ใน 4 GB แต่เสียที่เกือบ 1 GB ไปกับของที่ตอนนี้ไม่ได้ช่วยอะไร ส่วนที่ทำให้ 4 GB ไม่พอจริงๆ คือ build บนเครื่อง ที่กินถึง 2.9 GB ตอนเครื่องว่าง ถ้า build ระหว่างที่เว็บรันอยู่ เครื่องจะต้องลง swap ทั้งสองอย่างจึงถูกปิดไว้
5. Disk ของ Postgres ข้อนี้ยังไม่รู้ load test รอบแรกเขียนลง NVMe SSD ในโน้ตบุ๊ก ซึ่งอาจเร็วกว่าดิสก์ของ VPS และ Postgres ต้องรอดิสก์ทุกครั้งที่ commit บนเครื่องจริง ฐานข้อมูลอาจเป็นตัวที่ตันก่อน api ก็ได้ ต้องรอ load test รอบสองบนเซิร์ฟเวอร์ ซึ่งยังไม่ได้ทำ
อยู่ให้ได้ในเครื่องเล็ก: สิ่งที่ออกแบบหรือทำไว้
หลักคือให้เครื่องทำแค่งานที่ต้องอยู่ใกล้ข้อมูล งานหนักหรืองานที่ต้องรอดจากเครื่องตายให้ทำนอกเครื่อง
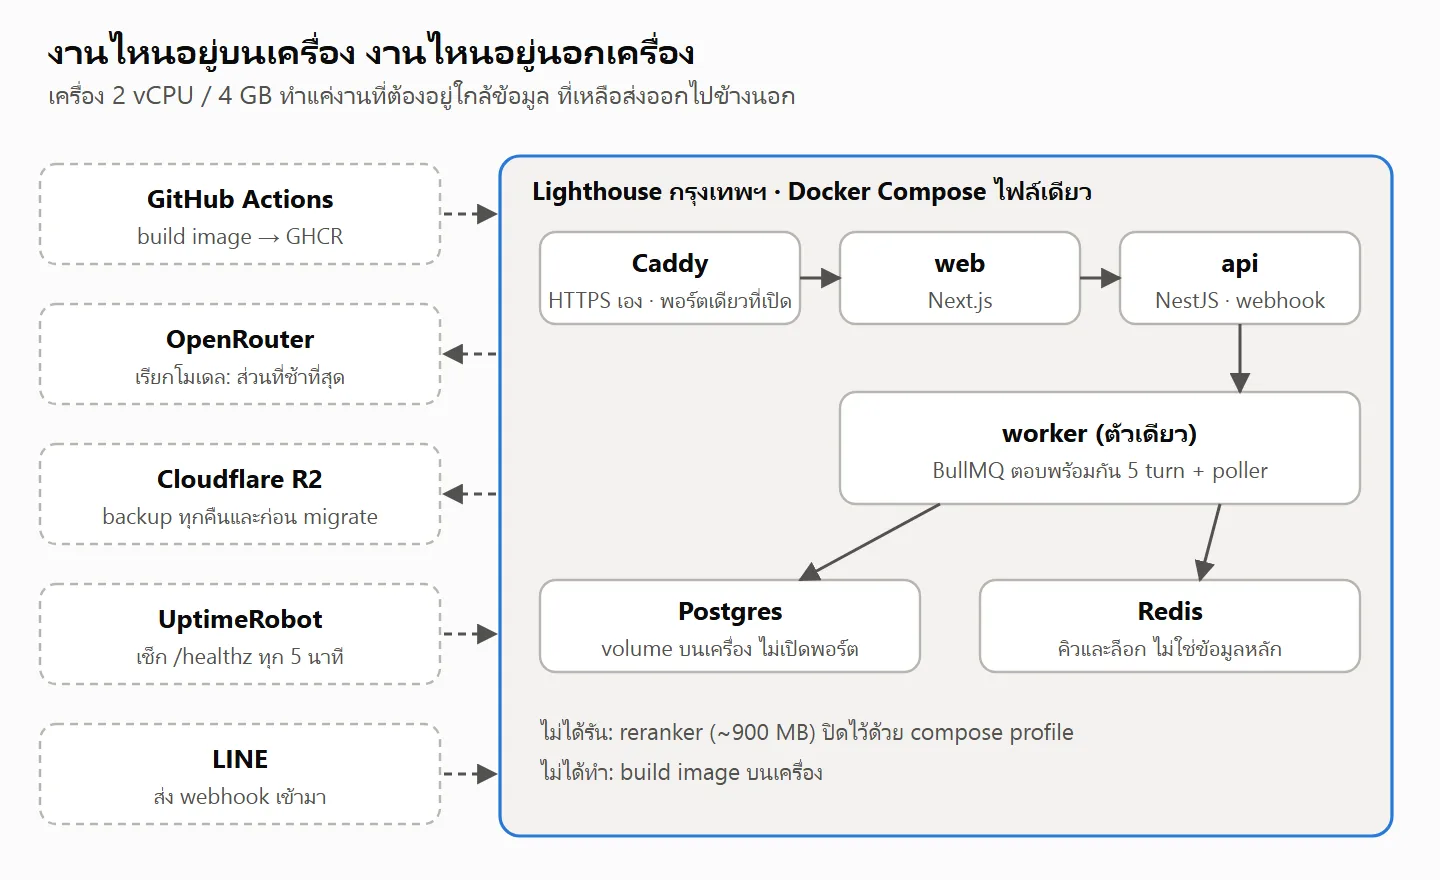
- เครื่องไม่ build อะไรเลย GitHub Actions build image สามตัวแล้ว push ขึ้น GHCR เครื่องแค่ pull ตาม commit SHA ทุกคำสั่ง
upใส่--no-buildถ้าวันไหน pull ไม่ได้ compose จะได้ไม่แอบ build บนเครื่องเอง รายละเอียดอยู่ในบทความ CI/CD - ส่วนที่ช้าที่สุดอยู่นอกเครื่อง การเรียกโมเดลผ่าน OpenRouter ใช้เวลาเกือบทั้ง turn แต่ไม่ได้ใช้ CPU ของเรา worker แค่รอ เครื่อง 2 vCPU จึงว่างเกือบตลอด ที่ต้องเพิ่มถ้าอยากรับงานมากขึ้นคือจำนวน turn ที่รันพร้อมกัน ไม่ใช่ core
- ข้อความที่ลูกค้าพิมพ์รัวๆ นับเป็น turn เดียว ระบบรอ 2.5 วินาทีหลังข้อความล่าสุด (แต่ไม่เกิน 8 วินาทีนับจากข้อความแรก) แล้วตอบทีเดียว ลูกค้าที่พิมพ์ห้าบรรทัดจึงใช้โมเดลครั้งเดียว ไม่ใช่ห้าครั้ง
- worker ตัวเดียว BullMQ จัดคิวของบอท ส่วนงานอื่นเป็น poller ที่ตั้งรอบตามความจำเป็น เช่น event ขาเข้าทุก 400 ms, การแจ้งเตือนการจองทุก 5 วินาที, เตือนนัดทุก 15 นาที และวางแผน follow-up ทุกชั่วโมง Redis เก็บแค่คิวกับล็อก ข้อมูลหลักอยู่ใน Postgres ถ้า Redis หาย turn ที่ค้างจะถูกสร้างใหม่จากฐานข้อมูล
- Postgres กับ Redis อยู่ใน Docker บนเครื่องเดียวกัน ไม่มีค่า managed database และ RLS, role กับ pgvector ทำงานเหมือนตอนทดสอบทุกอย่าง แลกกับการที่ผมต้องดูแล backup, upgrade และ restore เอง
- backup ออกนอกเครื่อง
pg_dumpไป Cloudflare R2 ทุกคืนและก่อน migrate ทุกครั้ง bucket ล็อกไว้ 30 วัน เครื่องที่ถูกเจาะจึงลบ backup ย้อนหลังไม่ได้ ผมซ้อม restore จาก R2 แล้ว ใช้เวลา 5 วินาที - Caddy แทน nginx Caddyfile 9 บรรทัด เทียบกับ nginx 52 บรรทัดบวกสคริปต์ทำ certificate Caddy ต่ออายุ certificate เอง ใน lab ที่ผมวัดไว้ nginx ที่จูนแล้วรับ request ได้มากกว่าราว 1.7 เท่า และใช้ memory ราว 6 MB เทียบกับ Caddy ราว 40 MB แต่เดโมนี้ต้องการแค่ไม่กี่ request ต่อวินาที ตัวเลขนี้จึงไม่ใช่ตัวตัดสิน
- ลด memory ของ process api กับ worker รันด้วย
node --import tsxตรงๆ ไม่ผ่านpnpmประหยัดได้ราว 90 MB ต่อ service ตอนว่าง reranker ปิดไว้ด้วย compose profile และถ้าไม่ตั้งRERANKER_URLการค้นหาก็ข้ามขั้น rerank ไปเอง ไม่ต้อง build ใหม่ - ลบของเก่าออกจากดิสก์
deploy.shลบ image เก่าของเราทุกครั้ง แต่เก็บเวอร์ชันก่อนหน้าที่ดีไว้หนึ่งชุดเผื่อ rollback log ของ container ถูกจำกัดที่ 3 × 10 MB ต่อ container ใน/etc/docker/daemon.jsonของเครื่อง ส่วนcompose.prod.ymlยังไม่ได้ตั้งloggingของตัวเอง (log ทั้งหมดตอนเช็กมีแค่ 3.9 MB เลยยังไม่รีบ) และมี swap รวม 3.9 GB โดยตั้งvm.swappiness=10ให้ใช้เฉพาะตอนจำเป็นจริง - เพดานกันคนเดียวผลาญทรัพยากร ลูกค้าหนึ่งคนส่งได้ไม่เกิน 10 ข้อความต่อนาที บอทตอบไม่เกิน 30 ครั้งต่อวัน ข้อความหนึ่งยาวได้ไม่เกิน 1,000 ตัวอักษร ค่า AI ไม่เกิน 0.25 ดอลลาร์ต่อลูกค้าต่อวัน ถ้าเกินในแชท บอทจะหยุดแล้วส่งต่อให้พนักงาน ส่วน LIFF API รับได้ 60 request ต่อนาทีต่อ IP เกินแล้วตอบ 429 เพดานพวกนี้ตั้งไว้เรื่องเงินและโควตาเป็นหลัก แต่ก็ทำให้คนเดียวยิงงานใส่เครื่องได้จำกัดด้วย
- เฝ้าจากสองฝั่ง watchdog ใน worker เช็กทุก 60 วินาทีว่ามีงานค้างหรือ poller พังหรือไม่ ส่วน UptimeRobot เช็ก
/healthzจากข้างนอกทุก 5 นาที เพราะถ้าเครื่องตาย watchdog ก็ตายไปด้วย ข้อที่ยังขาดคือ watchdog ยังตั้งเป็นOPS_ALERTS=logคือเขียน log อย่างเดียว ยังไม่ได้ส่งเข้า LINE
ถ้าวันหนึ่งไม่พอ จะทำอะไรก่อน
ลำดับนี้มาจากสิ่งที่วัดได้ว่าตันก่อน ไม่ได้มาจากการเดา
- บอทตอบช้าเพราะคิว เพิ่มจำนวน turn ที่รันพร้อมกันใน worker ไม่ต้องเพิ่มเครื่อง เพราะ worker แทบไม่ได้ใช้ CPU เพดานถัดไปคือ rate limit ของผู้ให้บริการโมเดล ซึ่งแก้ด้วยโมเดลสำรองจากผู้ให้บริการอื่น
- webhook ไม่ทัน รัน api สอง process ให้ใช้ core ที่สอง และให้ LINE ส่งตรงไปที่ api ไม่ต้องผ่าน web เพราะใน load test web ใช้ CPU ราว 45% ของหนึ่ง core ไปกับการส่งต่ออย่างเดียว
- ฐานข้อมูลตัน หรือมีร้านที่จ่ายเงิน ย้าย Postgres ไป managed database ด้วย
pg_dumpแล้ว restore จากนั้นเปลี่ยนDATABASE_URLไม่ต้องแก้โค้ด - อยากมี worker มากกว่าหนึ่งตัว ตอนนี้ทำไม่ได้ poller เขียนไว้ให้ process เดียว ตอนรับงานใช้
UPDATE … WHERE status = 'received'ธรรมดา ไม่มีFOR UPDATE SKIP LOCKEDและยังไม่เคยทดสอบการรันสองตัว ต้องเปลี่ยนการรับงานเป็นSKIP LOCKEDก่อน - ก่อนขยายไปหลายเครื่อง ต้องทำ image
petcare-appให้เล็กลงจาก 1.84 GB ตอนนี้มันรัน TypeScript ผ่านtsxและพก dev dependency ของทั้ง workspace มาด้วย ใช้งานได้ แต่docs/deploy.mdจดไว้ว่าควรทำให้เล็กลงก่อนรันหลายเครื่อง
ส่วนการอัปเกรดเครื่องเป็นขนาดใหญ่ขึ้นบน Lighthouse เอง ผมยังไม่ได้ลองและยังไม่ได้บันทึกขั้นตอนไว้
สิ่งที่ยังไม่ได้วัด
- load test รอบสองบนเซิร์ฟเวอร์จริง ทั้งเรื่องดิสก์และ CPU ของ VPS ตัวเลข CPU ทั้งหมดในบทความนี้มาจากโน้ตบุ๊กที่ถูกบีบให้เหลือสอง core
- memory ของ stack บนเครื่องหลังมีข้อมูลจริงและใช้งานไปนานๆ ตัวเลข 1.36 GB วัดตอนฐานข้อมูลยังว่าง ใน S2 memory ของ worker ขึ้นจากราว 117 MB เป็นราว 215 MB แล้วค้างอยู่ตรงนั้น ยังไม่รู้ว่าเป็น leak หรือไม่ ต้องรอ soak test
- CPU และ memory ระหว่าง deploy บนเครื่องจริง ซึ่งเป็นช่วงที่ api กับ worker boot พร้อมกัน
- traffic จริงหลังวันที่ 2 พฤศจิกายน ยังไม่ได้นับ
ค่าใช้จ่าย
- เครื่อง: 28.80 ดอลลาร์ปีแรก (ราคาปกติ 6 ดอลลาร์ต่อเดือน)
- R2, GHCR, GitHub Actions และ UptimeRobot: 0 ดอลลาร์ ทั้งหมดอยู่ใน free tier หรือฟรีสำหรับ repo นี้
- โมเดล: วันที่ทดสอบ LINE บน production ใช้ไปราว 0.03 ดอลลาร์ จากการวัดใน eval ค่าโมเดลอยู่ที่ 1.03–1.44 ดอลลาร์ต่อ 1,000 turn ร้านที่มี 1,000 turn ต่อเดือนจะจ่ายราว 1.20 ดอลลาร์
สรุปคือเครื่องขนาดนี้พอสำหรับเดโม เพราะงานที่หนักที่สุดสองอย่าง คือ build image กับเรียกโมเดล ไม่ได้เกิดบนเครื่อง ตัวที่จะตันก่อนคือคิวของบอทและโควตาของผู้ให้บริการโมเดล ไม่ใช่ CPU หรือ RAM ส่วนที่ยังไม่รู้คือดิสก์ ซึ่งต้องรอ load test บนเครื่องจริง
ที่มา
docs/cloud-journal/12-tencent-lighthouse.md— สเปก ราคา traffic, เครื่องเปล่า 546 MB และดิสก์ 7.2 GB, log ของ Docker 3 × 10 MBdocs/cloud-journal/14-first-deploy.md— swap, build บนเครื่อง 3 นาที 44 วินาที / 2.9 GB / swap 251 MB, ขนาด image, memory ทั้ง stack 1.36 GB แยกตาม servicedocs/cloud-journal/15-pipeline-live.md— turn กับโมเดลจริงบนเซิร์ฟเวอร์ 3.4–5.0 วินาที และราคาต่อ turn, backup 0.3 MB, ค่าใช้จ่าย R2/GHCR/Actionsdocs/cloud-journal/16-line-live.md— ข้อความจริงจากโทรศัพท์ 1.3–3.2 วินาที, turn 22 วินาที, ค่าโมเดลราว 0.03 ดอลลาร์ของวันนั้น, restore drill 5 วินาทีdocs/cloud-journal/17-uptime-monitor.md— UptimeRobot ทุก 5 นาทีdocs/deploy-choices.md— ทางเลือกที่พิจารณา, managed service ราวสิบเท่า, 4 GB เทียบ 2 GB, Postgres และ Redis ใน Docker, worker ตัวเดียวกับSKIP LOCKEDdocs/decisions.md— “The demo runs on Tencent Cloud Lighthouse, Bangkok”, “AWS to learn, Google Cloud to host” (20–25 ดอลลาร์ต่อเดือน), “How the demo is deployed” (ย้ายไป managed database), “Caddy over nginx for the demo”, “Spam and abuse limits”, “Cost and quota caps before the demo is public”docs/deploy.md— “Memory: what the stack uses” (846 MB / 1.76 GB, peak ตอน boot,node --import tsxประหยัดราว 90 MB), “Stopping and restarting the worker” (worker ตัวเดียว), “Alerts”, “Still missing before a real shop” (image 1.84 GB)docs/load-test-results.md— S1 run 1 และ run 2, S2 run 1 (ตาราง p50/p95, CPU ของ worker, memory ของ worker), “Known limits of round 1”docs/STATUS.md— การล้างแชทเมื่อ 2026-11-02 (8 บทสนทนา, 56 ข้อความ, 20 event), การล้าง build cache (19 → 16 GB, log 3.9 MB), 429 เมื่อ 2026-11-05,OPS_ALERTS=logdocs/eval-log.md— “What it has cost so far” (1.03–1.44 ดอลลาร์ต่อ 1,000 turn)compose.prod.yml— service, profile ของtoolsและreranker, ข้อมูลของ reranker (~900 MB, image 4 GB, 3.4–5 วินาทีเทียบงบ 800 ms)apps/api/src/worker/processors.ts(RESPOND_CONCURRENCY),apps/api/src/worker/pollers.service.ts(POLL_INTERVALS_MS),apps/api/src/worker/watchdog.ts(60 วินาที),packages/pipeline/src/types.ts(DEBOUNCE_MS,DEBOUNCE_DEADLINE_MS)