Merge แล้วขึ้นเว็บจริงเองในราว 15 นาที
CI/CD ของโปรเจกต์คนเดียวบนเซิร์ฟเวอร์ปีละ 28.80 ดอลลาร์
Petcare Assistant คือผู้ช่วย AI และ CRM บน LINE สำหรับร้านสัตว์เลี้ยง ผมทำคนเดียว และมีเดโมเปิดให้ลองที่ https://petcare.rattanun.dev ทุกวันนี้พอผม merge pull request เข้า main และ CI ผ่าน โค้ดชุดนั้นจะขึ้นเซิร์ฟเวอร์เองภายในประมาณ 15 นาที ไม่มีใครต้อง SSH เข้าไปพิมพ์คำสั่ง
บทความนี้เล่าว่า pipeline นี้ประกอบด้วยอะไร แต่ละขั้นมีไว้กันปัญหาอะไร ตัวเลขจริงเป็นเท่าไร อะไรเคยพัง และอะไรที่ยังต้องทำมือหรือยังไม่มี
ภาพรวมทั้งระบบ
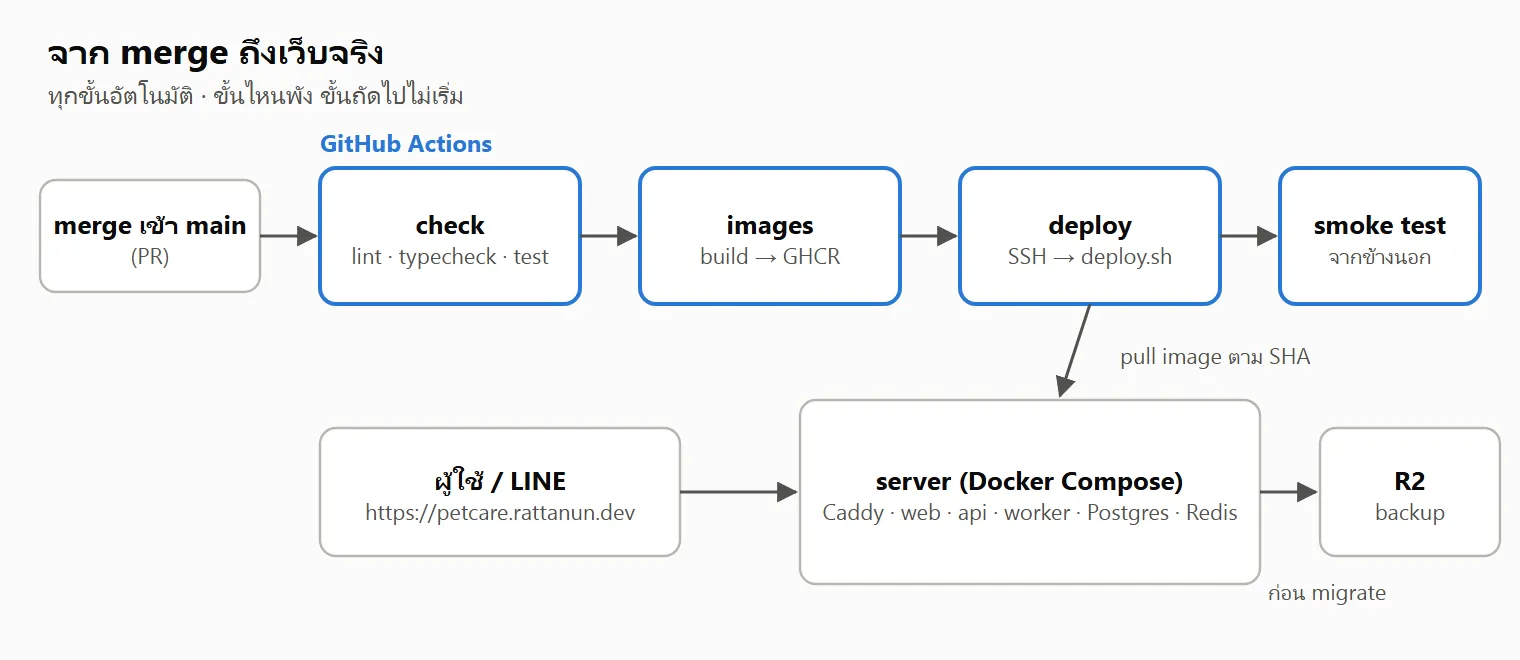
- โค้ด อยู่บน GitHub งานทุกชิ้นเข้า
mainผ่าน pull request - CI คือ GitHub Actions ไฟล์
ci.ymlมีสามช่วงหลัก ได้แก่check(format, lint, typecheck, เทสต์ราว 2,200 ตัวกับ Postgres จริง และ build),images(build image แล้ว push ขึ้น GitHub Container Registry หรือ GHCR) และdeploy - เซิร์ฟเวอร์ เป็น Tencent Cloud Lighthouse ที่กรุงเทพฯ ขนาด 2 vCPU, RAM 4 GB, SSD 60 GB ผมได้โปรโมชันลูกค้าใหม่ ปีแรกจ่าย 28.80 ดอลลาร์ (ราคาปกติเดือนละ 6 ดอลลาร์) บนเครื่องรัน Docker Compose มี Caddy อยู่หน้าสุดคอยทำ HTTPS ให้เอง
- Postgres และ Redis รันใน Docker บนเครื่องเดียวกัน ไม่ได้ใช้ managed database
- Backup ส่งออกนอกเครื่องไป Cloudflare R2 ทุกคืน และทุกครั้งก่อน migrate
ทั้งหมดเป็นเครื่องเดียว ถ้าเครื่องนี้ล่ม เดโมก็ล่ม ผมเขียนไว้ใน docs/deploy-choices.md ว่ายอมรับข้อนี้ได้สำหรับเดโม แต่ไม่ใช่สำหรับลูกค้าที่จ่ายเงินหลายร้าน
นอกจากนี้ ci.yml มี job ชื่อ changes ที่ diff ช่วงคอมมิตของ push นั้น ถ้า push แก้แค่ docs/**, labs/** หรือไฟล์ Markdown ก็จะไม่ build image และไม่ deploy การเขียนบันทึกหรือบทความแบบนี้จึงไม่ทำให้เซิร์ฟเวอร์รีสตาร์ต
ทำไม build ใน CI แล้วให้เซิร์ฟเวอร์แค่ pull
ก่อนทำ pipeline ผม deploy มือหนึ่งรอบ (cloud-journal 14) ตอนนั้น build image บนเซิร์ฟเวอร์เลย และวัดผลไว้
- ใช้เวลา 3 นาที 44 วินาที
- หน่วยความจำขึ้นไปสูงสุด 2.9 GB จาก 3.6 GB และใช้ swap อีก 251 MB
ตัวเลขนี้วัดตอนที่เครื่องยังไม่มีอะไรรันอยู่ แค่ build อย่างเดียวก็กินหน่วยความจำเกือบหมด ถ้า build ตอนเว็บกำลังให้บริการ เครื่องจะต้องลง swap และเว็บช้าลงทุกครั้งที่ deploy ส่วนตอนรันจริงทั้ง stack ใช้แค่ราว 1.36 GB
เพราะเหตุนี้จึงตัดสินใจว่าเซิร์ฟเวอร์ห้าม build อะไรเลย GitHub Actions เป็นคน build image สามตัว คือ petcare-web, petcare-app (api, worker และ migrate ใช้ image เดียวกัน) และ petcare-backup แต่ละตัวติด tag เป็น commit SHA เต็ม แล้ว push ขึ้น GHCR แบบ private โดยใช้ GITHUB_TOKEN ของ run นั้นเอง จึงไม่ต้องเก็บ secret ไว้สำหรับการ push ฝั่งเซิร์ฟเวอร์ login GHCR ด้วย token ที่มีสิทธิ์แค่ read:packages
ทุกคำสั่ง up บนเซิร์ฟเวอร์ต้องใส่ --no-build ถ้าไม่ใส่ แล้ววันไหน pull ไม่สำเร็จ compose จะหันไป build บนเครื่องแทน ซึ่งเป็นสิ่งที่ตั้งใจหลีกเลี่ยงตั้งแต่ต้น ส่วน build cache ที่หลงเหลือจาก build ครั้งนั้นกินดิสก์อยู่ 3.6 GB ผมเพิ่งลบไปเมื่อ 4 พฤศจิกายน
scripts/deploy.sh ทำอะไรบ้าง
job deploy ไม่ได้รันคำสั่งบนเซิร์ฟเวอร์เอง มันแค่ SSH เข้าไปพร้อม SHA หนึ่งค่า แล้วให้ scripts/deploy.sh ทำงานทั้งหมด สคริปต์หยุดทันทีที่ขั้นใดล้มเหลว
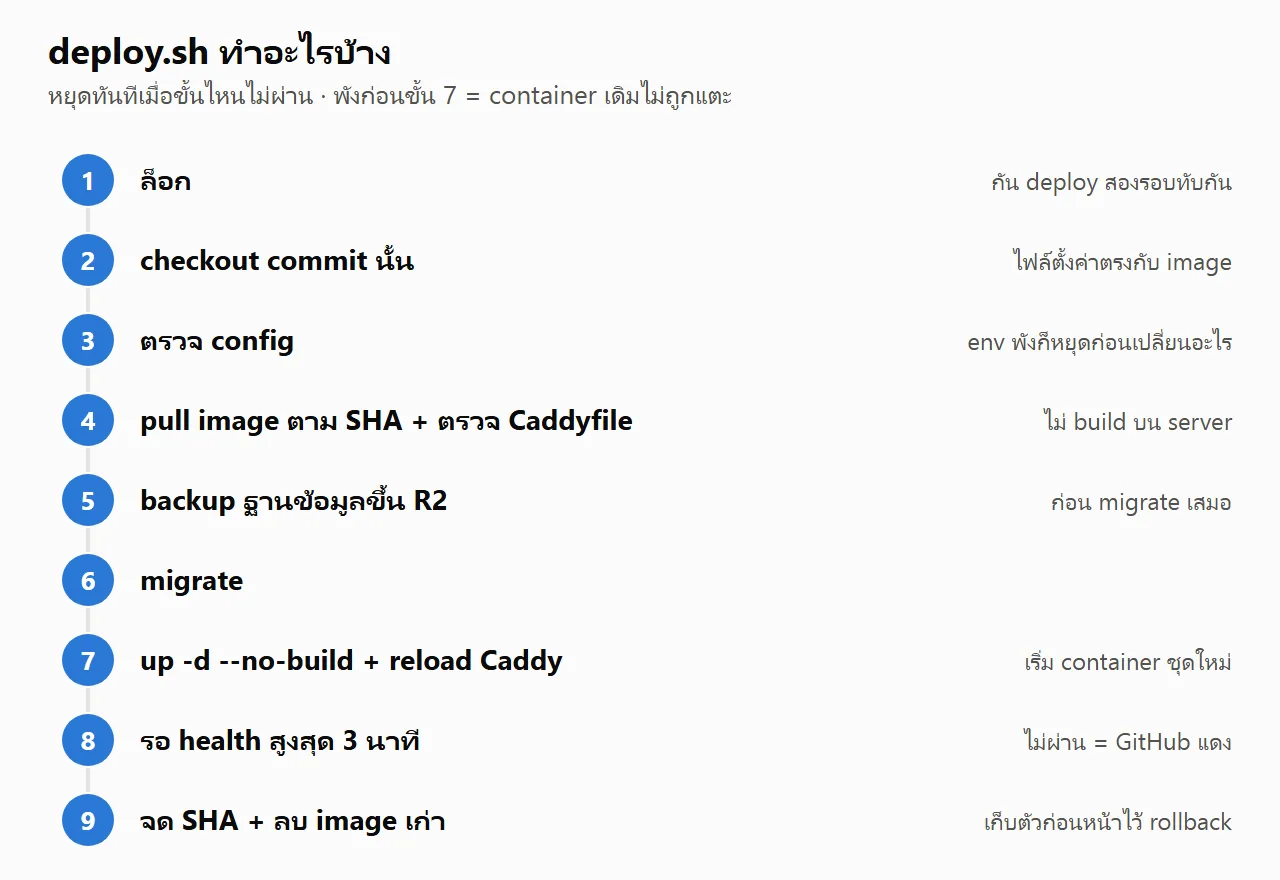
- ตรวจ input ก่อนทำอย่างอื่น รับได้แค่ SHA ตัวพิมพ์เล็ก 7–40 ตัว หรือคำว่า
latestค่าที่ส่งมาไม่เคยถูกส่งต่อให้ shell ตีความ - ล็อก ด้วย
flockเพื่อไม่ให้ deploy สองครั้งรันซ้อนกัน ฝั่ง GitHub มีconcurrency: deploy-productionที่ทำให้รันทีละอัน และห้ามยกเลิกกลางทางอยู่แล้ว แต่ล็อกนี้ครอบกรณีที่ผมสั่ง deploy มือบนเซิร์ฟเวอร์ระหว่างที่ GitHub กำลัง deploy อยู่ด้วย git fetchแล้ว checkout คอมมิตนั้นแบบ detached เพื่อให้compose.prod.yml,deploy/Caddyfileและสคริปต์ต่าง ๆ ตรงกับ image ที่จะรัน ถ้ามีคนแก้ไฟล์ที่ track อยู่บนเซิร์ฟเวอร์ สคริปต์จะปฏิเสธdocker compose config --quietถ้า.env.prodเสีย จะหยุดตรงนี้ก่อนที่อะไรจะเปลี่ยน ขั้นนี้เพิ่มเข้ามาหลังจากตอน deploy มือ มีคำสั่งที่ copy ค้างอยู่ใน clipboard หลุดเข้าไปอยู่ในไฟล์ env- pull image ของ SHA นั้น โดยระบุ service ชัดเจน ไม่ pull Postgres กับ Redis เพื่อไม่ให้การ deploy ย้ายฐานข้อมูลไป image ใหม่โดยไม่ตั้งใจ จากนั้น validate Caddyfile ด้วย Caddy image ตัวที่จะใช้ ถ้าพิมพ์ผิดจะได้เจอตรงนี้ แทนที่จะไปเจอตอนที่ทั้งเว็บล่ม
- backup ไป R2 ก่อน migrate ทุกครั้ง ถ้าไปทำ backup หลัง migration ที่พัง ก็จะได้ backup ที่มี migration พังติดมาด้วย ถ้า backup ไม่ผ่าน จะไม่ migrate และไม่รีสตาร์ตอะไรทั้งนั้น
- migrate ระหว่างที่เวอร์ชันเก่ายังให้บริการอยู่ migration จึงต้องเป็นแบบ additive เท่านั้น คือเพิ่มคอลัมน์ได้ แต่ห้ามเปลี่ยนชื่อ
- บันทึก
IMAGE_TAG=<sha>ลง.env.prodแล้วup -d --no-buildตามด้วย reload Caddy เพราะ Caddy อ่าน Caddyfile แค่ตอนเริ่ม ถ้าคอมมิตไหนแก้แค่ Caddyfile โดยไม่ reload ค่าใหม่จะไม่มีผล - รอ health ไม่เกิน 3 นาที web กับ api ต้อง
healthyและ worker ต้องไม่รีสตาร์ตเลย ถ้าไม่ผ่าน สคริปต์จะพิมพ์ log 60 บรรทัดสุดท้ายของ service ที่มีปัญหา แล้ว exit ด้วยค่าที่ไม่ใช่ 0 run บน GitHub จะเป็นสีแดง และ GitHub ส่งอีเมลแจ้งผม - บันทึก SHA ที่ deploy สำเร็จ แล้วลบ image เก่าของเราออก แต่ เก็บเวอร์ชันก่อนหน้าที่ดีไว้หนึ่งชุด เพื่อให้ rollback ได้ทันทีโดยไม่ต้อง pull ใหม่
มีกลไกเสริมอีกสองอย่าง อย่างแรก ถ้าล้มก่อนถึงขั้น up สคริปต์จะคืน checkout กลับไปที่คอมมิตเดิม เพราะ container ยังไม่ได้เปลี่ยน ไฟล์ข้างนอกก็ไม่ควรเปลี่ยนด้วย อย่างที่สอง สคริปต์ไม่สนสัญญาณ HUP และเขียน log ลงไฟล์บนเซิร์ฟเวอร์ด้วย tee -p ถ้า runner ของ GitHub ตายกลางทาง deploy จะไม่ค้างอยู่ระหว่าง migrate กับ up
ความปลอดภัยของเส้นทาง deploy
การให้ GitHub deploy เองแปลว่าต้องเก็บกุญแจเข้าเซิร์ฟเวอร์ไว้ใน GitHub ผมจึงจำกัดสิ่งที่กุญแจนี้ทำได้ให้เหลือแค่การ deploy
- SSH key แบบ forced command บรรทัดของ key นี้ใน
authorized_keysขึ้นต้นด้วยrestrict,command="/srv/petcare/scripts/deploy.sh"ไม่ว่าฝั่ง client จะสั่งอะไรมา เซิร์ฟเวอร์ก็จะรันแค่deploy.shสคริปต์อ่านคำสั่งที่ส่งมาจากSSH_ORIGINAL_COMMANDแล้วตรวจว่าเป็น SHA หรือไม่ ผมลองทดสอบด้วยwhoami,abc; idและการไม่ส่งคำสั่งเลย ทั้งสามแบบได้deploy: refusedกลับมา key นี้เปิด shell ไม่ได้ ถ้าถูกขโมยไป ทำได้มากที่สุดคือ deploy image ของเราเองเวอร์ชันอื่น - pin host key ไว้ใน secret
DEPLOY_KNOWN_HOSTSและ SSH ใช้StrictHostKeyChecking=yesการเชื่อมต่อจึงไม่ยอมเชื่อ key ที่เจอครั้งแรก ก่อนใส่ผมตรวจ host key กับ fingerprint ที่บันทึกไว้ตั้งแต่วันแรกที่ตั้งเครื่อง - ตรวจ SHA สองชั้น
deploy.ymlตรวจรูปแบบก่อนเชื่อมต่อ เพื่อให้พิมพ์ผิดแล้วล้มเร็ว แล้วdeploy.shตรวจซ้ำอีกรอบบนเซิร์ฟเวอร์ - secret อยู่ใน GitHub ได้แก่
DEPLOY_HOST,DEPLOY_USER,DEPLOY_SSH_KEY,DEPLOY_KNOWN_HOSTSprivate key ไปอยู่ใน secret แล้วถูกลบออกจากโน้ตบุ๊ก ใน job มี step ลบ key ออกจาก runner แบบif: always() - มีสวิตช์แยกจากการ merge job
deployรันเฉพาะตอนที่ตั้ง repository variableDEPLOY_URLไว้ ถ้าลบตัวแปรนี้ การ deploy อัตโนมัติจะหยุด
เซิร์ฟเวอร์ดึงโค้ดจาก GitHub ด้วย deploy key แบบอ่านอย่างเดียว ถ้ามีคนเจาะเครื่องได้ ก็แก้โค้ดบน GitHub จากเครื่องนั้นไม่ได้ ส่วน bucket ของ R2 ตั้ง bucket lock ไว้ 30 วัน ผมทดสอบด้วยการลองลบ object ทิ้ง ผลคือ ObjectLockedByBucketPolicy แปลว่าเครื่องที่ถูกเจาะก็ลบ backup ย้อนหลัง 30 วันไม่ได้
Smoke test จากภายนอก
deploy.sh ตรวจ health จากในเครื่องแล้ว แต่ยังไม่ได้พิสูจน์ว่าคนข้างนอกเข้าเว็บได้ หลัง deploy job บน GitHub จึงยิง request จากอินเทอร์เน็ตผ่าน DNS, TLS และ Caddy เหมือนผู้ใช้หรือ LINE จริง ๆ สามจุด
| Request | ต้องได้ | สิ่งที่พิสูจน์ |
|---|---|---|
GET /login |
200 (หรือ 401 ช่วงที่เว็บยังมี basic auth) | certificate ใช้ได้ (curl ตรวจให้) Caddy ตอบ และมี web อยู่ข้างหลัง ถ้าเป็น 5xx, timeout หรือ TLS error ถือว่าล้ม |
POST /api/webhooks/line/<uuid สุ่ม> |
401 ที่ body เป็น invalid signature และ ไม่มี WWW-Authenticate |
request เดินผ่าน Caddy → web → api ได้ครบ และ path ของ webhook ไม่ได้ติดรหัสผ่าน LINE จึงส่งเข้ามาได้ |
GET /healthz |
200 | api ต่อ Postgres และ Redis ได้ |
ข้อที่สองเป็นข้อที่ผมชอบที่สุด 401 ที่ Caddy ตอบเพราะ basic auth จะมี header WWW-Authenticate และไม่มี body แบบนั้น ส่วน 401 ของ api เองจะมีข้อความ invalid signature ถ้าดูแค่ status code ก็แยกสองกรณีนี้ไม่ออก นอกจากนี้ api ยังตอบ channel ที่ไม่รู้จักด้วยคำตอบเดียวกับ signature ผิด การยิง uuid สุ่มจึงไม่ทำให้ใครรู้ว่ามี channel ไหนอยู่ในระบบ
ส่วน /healthz ถ้าได้ 503 แปลว่าฐานข้อมูลหรือ Redis ล่ม ถ้าได้ 401 แปลว่า Caddyfile บนเซิร์ฟเวอร์ยังไม่ถูก reload
Continuous Delivery กับ Continuous Deployment
สองคำนี้ต่างกันตรงขั้นสุดท้าย Continuous Delivery คือทุกคอมมิตพร้อม deploy ได้เสมอ แต่ต้องมีคนกดอนุมัติก่อนขึ้นจริง ส่วน Continuous Deployment คือไม่มีขั้นอนุมัติ ผ่านแล้วขึ้นเลย
โปรเจกต์นี้เป็นแบบ Continuous Deployment ตั้งแต่ 26 ตุลาคม (decision D5 ใน docs/specs/M13e.md) ตอนแรกวางแผนไว้ว่าจะ deploy มือ แต่ผมอยากเรียนรู้ pipeline ให้ครบวงจร อีกเหตุผลคือ environment ที่มี required reviewer ต้องใช้ repository สาธารณะหรือ GitHub Enterprise แต่ repo นี้ยังเป็น private ราคาที่ต้องจ่ายคือ bug ที่เทสต์จับไม่ได้จะขึ้นเว็บจริงโดยไม่มีใครดูซ้ำ สำหรับเดโมผมรับได้ เพราะยังมีด่านอื่นกันอยู่
- CI เป็นด่านเดียวที่ต้องผ่าน ถ้า
checkไม่ผ่าน image ไม่ถูก build และไม่มีอะไรให้ deploy - backup ก่อน migrate ทุกครั้ง
- rollback ได้ด้วย pipeline เดิม เข้า Actions → Deploy → Run workflow (
workflow_dispatch) แล้วใส่ SHA ของเวอร์ชันที่ดีล่าสุด image ของเวอร์ชันก่อนหน้ายังอยู่บนเครื่อง จึงไม่ต้อง pull อะไรก้อนใหญ่ ข้อจำกัดคือ rollback ได้แค่โค้ด ฐานข้อมูลย้อนกลับไม่ได้ migration จึงต้องเป็น additive - health check ไม่ผ่าน run จะแดงและมีอีเมลแจ้ง
กติกาที่ตามมาคือ ห้าม commit เข้า main ตรง ๆ เพราะ main คือ production งานทุกชิ้นต้องเริ่มจาก branch แล้วเข้าผ่าน PR
กติกาของ pipeline ทั้งหมดในที่เดียว
mainคือ production ห้าม commit เข้าmainตรง ๆ ทุกงานเริ่มจาก branch แล้วเข้าผ่าน PR- รอ CI ของ PR เขียวก่อน merge CI บน
mainยังกันอีกชั้น แต่ถ้าพังจะได้รู้ใน PR ไม่ใช่หลังเข้าmain - merge แล้วขึ้นเว็บจริงเอง ไม่มีขั้นอนุมัติ ลำดับคือ
check→images→deployขั้นไหนไม่ผ่าน ขั้นถัดไปไม่เริ่ม - PR ที่แก้แค่เอกสาร (
docs/,labs/, ไฟล์.md) ไม่ build image และไม่ deploy ขั้นchangesในci.ymlเป็นตัวตัดสิน - CI รันทีละรอบต่อ branch บน PR push ใหม่ยกเลิก run เก่าทันที บน
mainrun ที่กำลังรันไม่ถูกยกเลิก เพราะอาจกำลัง push image หรือ deploy อยู่ ส่วนในคิวรอ GitHub เก็บไว้แค่ run ล่าสุด - deploy ทีละครั้ง
concurrency: deploy-productionฝั่ง GitHub กับflockฝั่งเซิร์ฟเวอร์ และห้ามยกเลิกกลางทาง - backup ก่อน migrate ทุกครั้ง backup ไม่ผ่าน deploy หยุด ไม่ migrate
- ไม่ผ่าน health check หรือ smoke test จากข้างนอก = run แดง และมีอีเมลแจ้ง
- rollback = deploy SHA เก่า ผ่าน Actions → Deploy → Run workflow ย้อนได้แค่โค้ด migration จึงต้องเพิ่มอย่างเดียว ไม่ลบไม่แก้ของเดิม
- หยุด deploy อัตโนมัติชั่วคราว ทำได้ด้วยการเอาตัวแปร
DEPLOY_URLใน GitHub ออก
ตัวเลขจริง
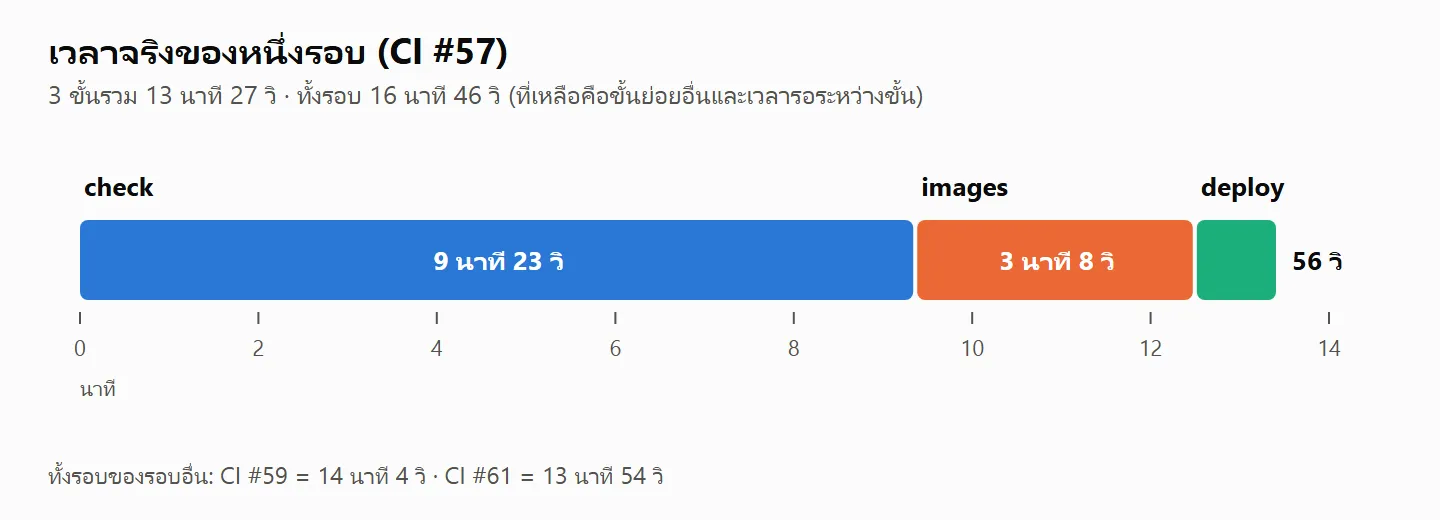
- CI #57: check 9 นาที 23 วินาที, images 3 นาที 8 วินาที, deploy 56 วินาที รวม 16 นาที 46 วินาที
- CI #59: รวม 14 นาที 4 วินาที
- CI #61: รวม 13 นาที 54 วินาที
เวลาส่วนใหญ่หมดไปกับ check ส่วนการ deploy จริงบนเซิร์ฟเวอร์ใช้ไม่ถึงนาที deploy ครั้งแรกผ่าน pipeline เมื่อ 27 ตุลาคม ตัว deploy.sh ใช้ 32 วินาที รวม backup และ migration สองตัว Postgres กับ Redis ไม่ถูกรีสตาร์ต เว็บล่มไปราว 1.5 นาทีในวันนั้น ทั้งหมดมาจากการสลับ Caddy ตัวทดลองไปเป็นตัวจริง ซึ่งทำครั้งเดียว ส่วน backup แต่ละครั้งมีขนาดราว 0.3 MB ใช้เวลาไม่กี่วินาที
สิ่งที่พังและบทเรียน
- PR ถูก merge ก่อนที่ fix ของคำสั่ง backup จะตามมา
deploy.shต้องรัน backup ด้วย--profile toolsถ้าไม่ใส่ compose จะเปิด container ขึ้นมาแต่ไม่อ่าน.env.backupได้ backup ที่ไม่รู้ว่าจะส่งไป bucket ไหน รอบนั้นไม่เสียหายเพราะยังไม่ได้ตั้งDEPLOY_URLการมีสวิตช์แยกจากการ merge ช่วยไว้ตรงนี้ - นาฬิกาเซิร์ฟเวอร์เป็น
Asia/Shanghaiไม่ใช่ UTC ทั้งเอกสาร agent และตัวผมเองคิดว่าเป็น UTC มาเจอตอนติดตั้ง cron ของ backup ถ้าไม่เจอ backup ที่ตั้งไว้ตี 3:15 เวลากรุงเทพฯ จะรันตอน 19:15 ทุกคืนโดยไม่มีใครรู้ บทเรียนคือตั้งค่าอะไรแล้วต้องพิมพ์ออกมาอ่านดูจริง ๆ - ปุ่มติดตั้ง rich menu ใช้ได้ตอน dev แต่พังใน image ด้วย
ENOENTNext แบบ standalone copy เฉพาะไฟล์ที่โค้ด import ไฟล์ PNG ที่อ่านด้วยreadFileจึงไม่ถูกใส่ลงไปใน image แก้ด้วยoutputFileTracingIncludesปัญหาแบบนี้ไม่มีทางเห็นจาก dev server - หน้า LIFF ขาวโพลนใน LINE เพราะตอนนั้นเว็บยังติด basic auth ผมเปิด
/api/liff/*ไว้แล้ว แต่ลืมตัวหน้า/liff/*กับสคริปต์/_next/*และ browser ใน LINE ไม่แสดงช่องกรอกรหัสผ่าน มันแค่แสดงหน้าว่าง - แก้ Caddyfile แล้วค่าใหม่ไม่มีผล มีสองสาเหตุซ้อนกัน สาเหตุแรก การ bind-mount ไฟล์เดียวจะผูกกับ inode ของไฟล์ แต่
git checkoutเขียนไฟล์ใหม่ทับ Caddy จึงยังเห็นไฟล์เก่าอยู่ แก้ด้วยการ mount ทั้งโฟลเดอร์ สาเหตุที่สองdeploy.shยังไม่ได้ reload Caddy ตอนนี้สคริปต์ validate ก่อนและ reload หลังupทุกครั้ง - คอมมิตหนึ่งหลุดเข้า
mainตรง ๆ เพราะ branch ที่ใช้ทำงานตั้ง upstream ไว้เป็นorigin/mainพอ push จึงไปลงmainแทนที่จะลง branch ของตัวเอง ทั้งที่กติกาเขียนไว้ชัดแล้ว และใน repo นี้mainคือ production - PR ถูก merge ก่อนที่ CI ของมันจะรันจบ เกิดขึ้นหลายครั้ง ไม่เสียหาย เพราะ CI บน
mainยังเป็นด่านก่อน deploy ถ้ามันแดงตั้งแต่checkก็ไม่มีอะไรถูก deploy และเว็บจริงยังเป็นเวอร์ชันเดิมที่ดีอยู่ สิ่งที่เสียคือmainมีโค้ดที่ขึ้นไม่ได้ ทุก merge ถัดไปจะติดจนกว่าจะแก้ และผมได้รู้ว่าพังตอนที่มันเข้าmainไปแล้ว แทนที่จะรู้ใน PR - run ที่ถูกยกเลิกเองบน
mainวันหนึ่งผม merge สาม PR ติดกัน run แรกยังรันอยู่ run ที่สองที่รอคิวขึ้นสถานะ cancelled พร้อมข้อความ “Canceling since a higher priority waiting request … exists” ดูน่าตกใจ แต่เป็นกติกาของconcurrencyปกติ run ที่กำลังรันไม่ถูกยกเลิก แต่ในคิวรอ GitHub เก็บไว้แค่ run ล่าสุด ซึ่งมีโค้ดของ run ที่ถูกยกเลิกอยู่แล้ว
ที่ยังทำมือหรือยังไม่มี
- ระบบแจ้งเตือนยังไม่ได้เปิดจริง watchdog ใน worker ยังตั้งเป็น
OPS_ALERTS=logคือเขียนลง log อย่างเดียว ไม่ส่งไปไหน ปลายตุลาคม OpenAI embedding key หมดอายุ ระบบค้นหา knowledge บน production พังไปราวสี่วันโดยไม่มีอะไรเตือนเลย ผมรู้เพราะลองถามบอทใน LINE แล้วบอทตอบว่าสาขาบางนาไม่มีข้อมูลที่จอดรถ - UptimeRobot ทำได้แค่เช็ก ทุก 5 นาทีที่
/healthzแล้วส่งอีเมลถ้าเว็บล่ม ตอนแรกผมตั้งให้เช็กหน้า/liff/...ซึ่ง web เสิร์ฟเองทั้งหมด ถ้าฐานข้อมูลล่ม มันก็ยังเป็นสีเขียวอยู่ บทเรียนคือ uptime check พิสูจน์ได้แค่สิ่งที่ URL นั้นต้องพึ่ง - GHCR pull token อายุ 90 วัน หมดราวปลายมกราคม 2027 ต้องต่ออายุเองด้วยมือ
- ไม่มี staging migration จะเจอข้อมูลจริงครั้งแรกบน production และไม่มีระบบรวม log มีแค่
docker compose logsบนเครื่อง - restore drill ยังรันมือ ตั้งใจไว้ว่าเดือนละครั้ง ครั้งที่บันทึกไว้เมื่อ 28 ตุลาคม ดึง dump ล่าสุดจาก R2 มา restore ลงฐานข้อมูลชั่วคราวได้ภายใน 5 วินาที แล้วลบฐานนั้นทิ้ง
- หลัง deploy ยังต้องเช็กเองบางอย่าง เช่น ส่งข้อความหา OA แล้วดูว่าบอทตอบหรือไม่ เพราะ smoke test ไม่ได้คุยกับโมเดลจริง
สรุปคือ pipeline นี้ทำให้การ merge เป็นงานที่น่าเบื่อแบบที่ควรเป็น แต่ยังไม่ได้ทำให้ผมรู้ทันทีเมื่อมีอะไรพังหลัง deploy ไปแล้ว งานถัดไปจึงเป็นเรื่องการแจ้งเตือน ไม่ใช่เรื่อง deploy
ที่มา
.github/workflows/ci.yml— ลำดับ job (check, changes, images, deploy), การข้าม push ที่แก้แค่เอกสาร, สวิตช์DEPLOY_URL.github/workflows/images.yml— image สามตัว, tag ตาม SHA, push ด้วยGITHUB_TOKEN.github/workflows/deploy.yml— การตรวจ SHA, pin host key, SSH ไปยัง forced command, smoke test สามจุด,workflow_dispatchสำหรับ rollbackscripts/deploy.sh— header comments และmain(): lock, checkout, config, pull, validate Caddyfile, backup, migrate, up, reload Caddy, health wait, prunescripts/backup.sh,scripts/restore-drill.sh— header commentscompose.prod.yml— comments ของ servicebackupและcaddydocs/deploy.md— “Deploying a new version”, “After a deploy, check these”, “Rolling back”, “Alerts”, “Still missing before a real shop”docs/deploy-choices.md— สเปกและราคาเครื่อง, build ใน CI, Postgres ใน Docker, การ deploy อัตโนมัติไม่มีขั้นอนุมัติdocs/specs/M13e.md— D5 และบันทึกการตัดสินใจของ T1/T3docs/cloud-journal/12-tencent-lighthouse.md,13-domain-https.md,14-first-deploy.md(ตัวเลข build บนเซิร์ฟเวอร์),15-pipeline-live.md(deploy แรก 32 วินาที, forced command, timezone, bucket lock),16-line-live.md(rich menu, LIFF, PR ที่ merge ก่อน CI จบ),17-uptime-monitor.mddocs/decisions.md— “Files read at run time must be listed for Next’s standalone trace”, “Caddy mounts the wholedeploy/folder, and/healthzskips the password”docs/STATUS.md— embedding key หมดอายุ,fix/m13e-t3-backup-profile, การล้าง build cache, วันหมดอายุของ GHCR tokendocs/portfolio-notes.md— “How it is deployed”- เวลาของ CI #57, #59, #61 — เจ้าของโปรเจกต์ดูจากหน้า GitHub Actions
- คอมมิตที่หลุดเข้า
mainเพราะ branch ตั้ง upstream เป็นorigin/main— เจ้าของโปรเจกต์เล่าเอง ไม่มีบันทึกใน repo