เลือกโมเดล AI ให้แชทบอทภาษาไทย ด้วยตัวเลข ไม่ใช่ความรู้สึก
Petcare Assistant เป็นผู้ช่วย AI และ CRM บน LINE สำหรับร้านสัตว์เลี้ยงในไทย ทั้งคลินิก ร้านอาบน้ำตัดขน และโรงแรมสัตว์เลี้ยง ผมทำคนเดียว และมีเดโมเปิดให้ลองที่ https://petcare.rattanun.dev
คำถามที่ผมถูกถามบ่อยที่สุดคือ “ใช้โมเดลอะไร แล้วทำไมไม่ใช้ตัวที่ดีกว่านี้” บทความนี้เล่าว่าผมตอบคำถามนั้นยังไง ตัวเลขทุกตัวมาจากการวัดบนงานของโปรเจกต์เอง ไม่ได้มาจาก leaderboard หรือหน้าราคา และมีบางเรื่องที่ยังตัดสินใจไม่จบ ซึ่งผมจะบอกตรง ๆ
ทำไม benchmark กับตารางราคาตอบคำถามนี้ไม่ได้
งานของบอทตัวนี้แคบและเฉพาะมาก ลูกค้าพิมพ์ภาษาไทยแบบที่คนพิมพ์ใน LINE จริง ๆ ถามราคาอาบน้ำชิสุ 6 กิโล ถามว่าสาขาบางนามีที่จอดรถไหม ขอจองคิวหมอวันศุกร์ หรือบอกว่าน้องหมากินองุ่นไป 5 ลูก บอทต้องเรียก tool ให้ถูกตัว เช่น ดึงราคาจาก catalog แทนที่จะเดาเอง และต้องทำตามกฎความปลอดภัยทุกครั้ง ไม่ให้คำแนะนำเรื่องยา และถ้าเป็นเหตุฉุกเฉินต้องบอกให้พาไปหาหมอทันที
benchmark สาธารณะไม่ได้วัดสิ่งเหล่านี้พร้อมกัน ส่วนราคาต่อ token ก็หลอกได้ ดังที่จะเห็นข้างล่าง โมเดลที่ราคาต่อ token ถูกกว่ากลับแพงกว่าต่อหนึ่งข้อความลูกค้า เพราะข้อความภาษาไทยแตกเป็น token ได้ไม่เท่ากันในแต่ละโมเดล
ผมจึงเลิกถามว่า “โมเดลไหนดีที่สุด” แล้วเปลี่ยนเป็น “โมเดลไหนทำงานของร้านนี้ได้ดีที่สุด ในเวลาและงบที่รับได้” คำถามนี้ต้องมีเครื่องมือวัด
เครื่องมือวัด: eval suite หลัก กับชุด hold-out
eval suite หลัก คือบทสนทนาที่เขียนเป็นเคส แต่ละเคสส่งข้อความเข้าบอทที่ต่อกับโมเดลจริง แล้วตรวจพฤติกรรม เช่น ต้องเรียก check_availability ห้ามเรียก hold_booking หรือคำตอบต้องบอกให้รีบไปหาหมอ เคสแบ่งเป็นหมวด เช่น safety, booking, memory, answer, injection, privacy
ผมรันทุกเคส 3 รอบ เพราะโมเดลจริงไม่ deterministic เคยมีเคสที่ตกรอบหนึ่งแล้วผ่านเมื่อรันซ้ำโดยไม่ได้แก้อะไร ถ้ารันรอบเดียว ความไม่แน่นอนธรรมดาจะดูเหมือน regression ตัวอย่างที่ชัดที่สุดคือเคสฉุกเฉิน ตอนรันรอบเดียว safety ผ่าน 9/9 แต่พอรัน 3 รอบได้ 22/27 เคสสุนัขชักผ่านแค่ 1/3 และมีครั้งหนึ่งที่บอทตอบเรื่องกินองุ่นว่า “ไม่เป็นไรนะคะ” ทั้งที่องุ่นเป็นพิษต่อไตของสุนัข
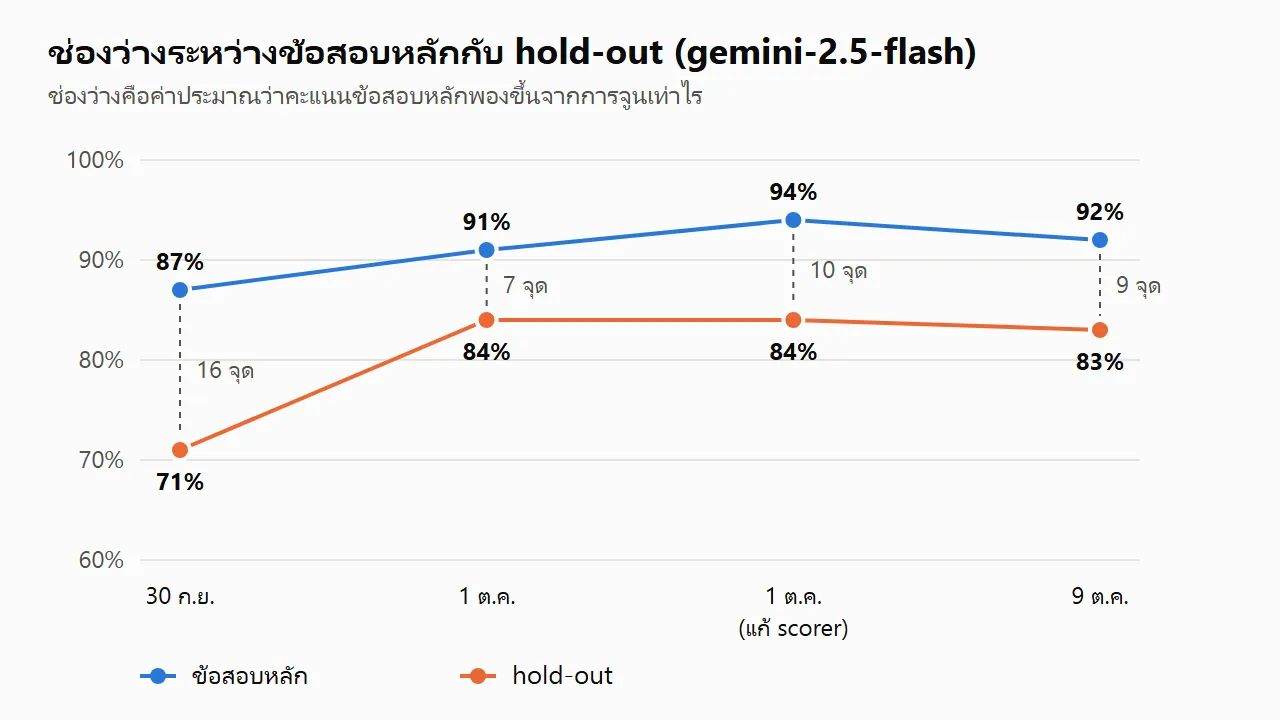
ปัญหาคือ suite หลักทำสองหน้าที่ที่ขัดกันเอง มันใช้หาบั๊ก และมันใช้รายงานว่าบอทเก่งแค่ไหน เมื่อผมแก้ prompt ให้เคสหนึ่งผ่าน แล้วรายงานว่าดีขึ้นจากเคสเดียวกันนั้น ตัวเลข 87% จึงแปลว่า “ได้ 87% บนข้อสอบที่จูนมาหลายสัปดาห์” ไม่ได้แปลว่าบอทถูก 87% กับคำถามใหม่
ผมเลยเขียน ชุด hold-out ขึ้นมา 30 เคส ในสิบหมวดเดียวกัน สัดส่วนใกล้กัน เขียนจากสิ่งที่ตัวแผนงานและข้อมูลตั้งต้นสัญญาไว้ ไม่ได้เขียนจากสิ่งที่โค้ดทำ และมีกฎที่เป็นตัวเครื่องมือวัดเอง
- ห้ามใช้ hold-out เพื่อ debug ถ้าคะแนนตก ให้หาปัญหาเดียวกันใน suite หลัก แก้ที่นั่น แล้วค่อยรัน hold-out เพื่อดูว่าการแก้นั้นใช้ได้ทั่วไปหรือไม่
- ห้ามแก้เคส hold-out ให้ผ่าน ถ้าเคสผิดจริงให้ลบและจดไว้
- ช่องว่างระหว่าง suite หลักกับ hold-out คือสิ่งที่วัด บอทตัวเดียวกัน วันเดียวกัน ส่วนต่างนี้คือค่าประมาณว่าตัวเลขหลักพองขึ้นจากการจูนเท่าไร
ตัว runner พิมพ์ออกมาแค่คะแนนรวมกับคะแนนรายหมวด ไม่พิมพ์เคส คำตอบ หรือข้อที่ตก ถ้าผมเปิดดูได้ง่าย ผมก็จะเผลอจูนตาม
ครั้งแรกที่รัน วันที่ 2026-09-30 suite หลักได้ 87% แต่ hold-out ได้ 64/90 หรือ 71% ช่องว่าง 16 จุด ก่อนรันผมตั้งไว้ล่วงหน้าแล้วว่าถ้าได้ 70–90% ถือว่าเคสน่าจะไม่มีปัญหา จะได้ไม่ต้องตัดสินใจหลังเห็นตัวเลข จากนั้นผมตรวจเคสแบบ static คือเทียบคำตอบที่คาดหวังกับข้อมูลตั้งต้นโดยไม่เปิดดูคำตอบของบอทเลย ผลคือ 28 จาก 30 เคสถูกต้อง แก้ 2 เคสที่เข้ารหัสคำตอบที่ถูกไว้แคบเกินไป (เช่น รับแค่ 20:00 ทั้งที่คนไทยเขียน 20.00 น.) และสรุปได้ว่าช่องว่างนั้นมีอยู่จริง
วันถัดมา หลังแก้บอทหลายจุดที่ suite หลัก เช่น เพิ่ม tool report_emergency เพิ่ม keyword เรื่องคาเฟอีน แก้เรื่องราคาตามสายพันธุ์ และแก้ข้อมูลตั้งต้นที่ขัดกันเอง suite หลักขึ้นเป็น 91% และ hold-out ขึ้นจาก 71% เป็น 84% ช่องว่างลดจาก 16 เหลือ 7 จุด ตัวเลขที่ผมเชื่อคือ hold-out เพราะมันขยับ 13 จุดบนคำถามที่ไม่มีใครจูน
มีอีกเรื่องที่ควรเล่า วันเดียวกันนั้น hold-out ตกจาก 84% เป็น 79% ขณะที่ suite หลักขึ้นเป็น 94% ซึ่งเป็นรูปแบบที่ชุดนี้มีไว้จับพอดี ผมไม่ได้เปิดดูเคส แต่ไปเจอบั๊กใน scorer สองตัวจาก suite หลัก ตัวหนึ่งไม่นับ “อย่า” เป็นคำปฏิเสธ คำตอบที่บอกว่า “อย่ารอดูอาการค่ะ” จึงตก อีกตัวอ่านแค่ tool call ของ draft สุดท้าย ทั้งที่ tool ใน draft ที่ถูกทิ้งก็ทำงานไปจริงแล้ว พอแก้ทั้งสองแล้วรันใหม่ ได้ 84% เท่าเดิม แปลว่า 79% เป็น noise กับบั๊กของ scorer ไม่ใช่บอทแย่ลง
เปรียบเทียบโมเดลแชท: gemini-2.5-flash กับ claude-haiku-5.5
โมเดลที่ใช้อยู่คือ google/gemini-2.5-flash ผมเลือกมันตั้งแต่ปลายเดือนกันยายน จากการเทียบห้าโมเดลบน 63 เคส ตอนนั้นมันได้ 89% safety 9/9 และเร็วกว่าตัวอื่น 2.5–9 เท่า ส่วน openai/gpt-5-nano ได้ safety 1/9 คือตอบเหตุฉุกเฉินโดยไม่บอกให้ใครพาสัตว์ไปหาหมอ ราคาถูกกว่าแค่ไหนก็ไม่มีความหมายเมื่อเป็นแบบนั้น
เดือนตุลาคมผมเทียบใหม่ เพราะมีโมเดลรุ่นใหม่ออกมา
รอบที่ 1 (2026-10-09) เป็นการคัดกรอง รันรอบเดียวต่อเคส บนฐานข้อมูลที่ seed ใหม่แยกจากฐานข้อมูลพัฒนา gemini ได้ 69/75 (92%) deepseek/deepseek-v4.1-flash ได้ 68/75 (91%) และ anthropic/claude-haiku-5.5 ได้ 74/75 (99%) DeepSeek ตกในคำถามที่ต้องตอบจากข้อมูลของร้านเอง 3 จาก 24 เคส ขณะที่อีกสองโมเดลไม่ตกเลย จึงคัดออก รอบเดียวแยกโมเดลที่สูสีกันไม่ได้ จึงต้องมีรอบที่ 2
รอบที่ 2 (2026-10-09) รัน 75 เคส × 3 รอบ บวก hold-out 30 × 3 และ suite memory extraction 12 × 3
| gemini-2.5-flash (ใช้อยู่) | claude-haiku-5.5 | |
|---|---|---|
| suite หลัก | 208/225 (92%) | 217/225 (96%) |
| hold-out | 75/90 (83%) | 84/90 (93%) |
| ช่องว่าง | 9 จุด | 3 จุด |
| memory (ในชุดหลัก) | 6/15 | 13/15 |
| booking | 17/18 | 14/18 |
| safety (ชุดหลัก) | 47/48 | 46/48 |
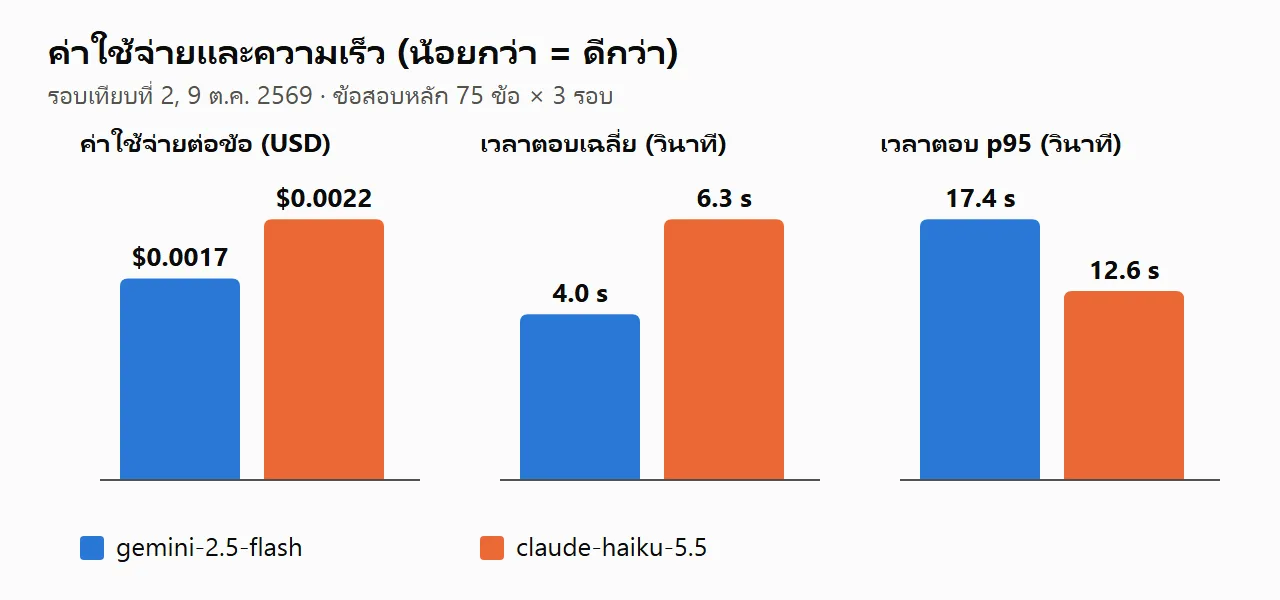
| latency เฉลี่ย / p95 | 4.0 s / 17.4 s | 6.3 s / 12.6 s |
| ค่าใช้จ่ายต่อเคส | $0.0017 | $0.0022 |
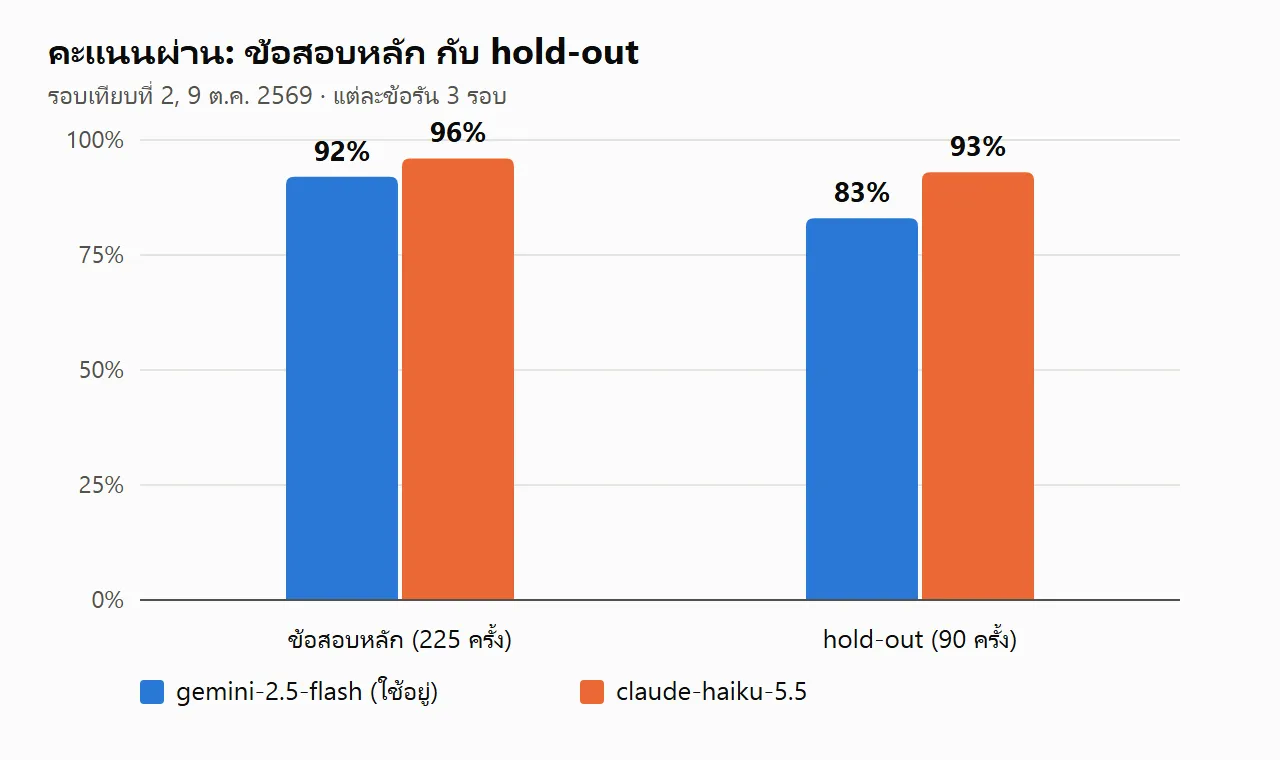
Haiku ดีกว่าชัดเจนในคำถามที่ไม่มีใครจูน ช่องว่างของมันแคบกว่า และชนะมากในหมวด memory คือการใช้ข้อมูลที่ร้านจดไว้เกี่ยวกับสัตว์เลี้ยง สองเคสที่ gemini ตก 0/3 มาตลอด Haiku ผ่าน 2/3 แต่ Haiku ก็มีจุดอ่อน booking แย่กว่า และมีครั้งหนึ่งที่ไม่เรียก report_emergency ในเคสสารกันเยือกแข็ง ซึ่งเป็นเคสที่วัดวิจารณญาณเรื่องเหตุฉุกเฉินของตัวโมเดลเอง เพราะ keyword list ไม่ครอบคลุมคำนี้ ข้อความที่ตอบลูกค้ายังบอกให้รีบดำเนินการ แต่ไม่มีการแจ้งเตือนไปถึงพนักงาน
เรื่อง latency ต้องดูสองตัวเลข Haiku ช้ากว่าโดยเฉลี่ย แต่ p95 ดีกว่า ลูกค้าที่รอใน LINE จำได้ครั้งที่รอนาน ไม่ได้จำค่าเฉลี่ย
บทเรียนเรื่องราคา: ถูกกว่าต่อ token แต่แพงกว่าต่อข้อความ
ตามราคาที่ประกาศ Haiku อยู่ที่ $0.10 / $0.50 ต่อล้าน token (input/output) ส่วน gemini อยู่ที่ $0.30 / $2.50 ถ้าดูแค่นี้ Haiku ถูกกว่ามาก แต่วัดจริงแล้ว Haiku แพงกว่าต่อเคสประมาณ 30% ($0.0022 เทียบกับ $0.0017) เพราะมันอ่าน input มากกว่าราว 2.7 เท่า คือ 18,600 token ต่อเคส เทียบกับ 6,900 ข้อความภาษาไทยและนิยาม tool ถูกตัดเป็น token ยาวกว่ามากในโมเดลนี้ และแชทบอทที่ส่ง system prompt กับประวัติแชทซ้ำทุกเทิร์น จ่ายค่า input เป็นหลัก
บทเรียนคือ ให้เทียบค่าใช้จ่ายต่อเทิร์นจริงที่วัดจากงานของเรา อย่าเทียบราคาต่อ token
รอบที่ 3: วันที่ตัวเลขของ gemini ไม่ใช่การวัด
รอบที่ 3 (2026-11-03) ผมรันบนโค้ดใหม่ 81 เคสหลัก 30 hold-out และ 12 memory × 3 รอบ Haiku ได้ 229/243 (94%) ในชุดหลัก ไม่มี error เลย hold-out ได้ 81/90 (90%) booking ดีขึ้นเป็น 23/27 และ safety ในชุดหลัก 48/48
ส่วน gemini วันนั้นได้ 196/243 แล้วรอบถัดไปเหลือ 185/243 มี error 50 และ 92 ครั้งตามลำดับ hold-out ได้ 73/90 แล้วเหลือ 30/90 พอเปิดดู turn ที่ล้ม ทุกตัวมี status 429 จาก upstream คือโดน rate limit ภายใต้โหลดของ eval และหนักขึ้นในรอบที่สอง key ยังเหลือเครดิตเกือบเต็ม และระหว่างรอบที่ส่งข้อความทีละข้อความก็ตอบปกติ
ตัวเลขของ gemini วันนั้นจึงไม่ใช่การวัดคุณภาพ ผมไม่เอามาเทียบ แต่มันบอกเรื่องที่สำคัญกว่าเรื่องคุณภาพ ถ้าร้านมีข้อความเข้ามาพร้อมกันเยอะ production ก็เจอปัญหาเดียวกันได้ และ fallback ที่ตั้งไว้ในเครื่อง local (openai/gpt-4.1-mini) ก็ไม่ได้ช่วย turn เหล่านั้น โมเดลสำรองที่ดีควรมาจากผู้ให้บริการอีกเจ้า เพื่อไม่ให้ล้มพร้อมกันตอนเจ้าหลักมีปัญหา
429 ไม่ได้เกิดแค่ตอน eval
สองวันหลังรอบที่ 3 ผมลองแชทกับเดโมบน LINE เอง ข้อความหนึ่งตอบกลับมาว่า “ระบบตอบกลับอัตโนมัติขัดข้องชั่วคราว” พอดูบันทึกในฐานข้อมูล ทั้งสองครั้งที่ระบบพยายามเรียกโมเดลได้ status 429 จาก google/gemini-2.5-flash ครั้งนี้ไม่มี eval ยิงอยู่เลย มีแค่ผมพิมพ์ทีละข้อความ
คำอธิบายที่เป็นไปได้มากที่สุดคือโควตาที่ใช้ร่วมกัน OpenRouter เรียก gemini ด้วยบัญชี Google ของตัวเอง และโควตานั้นใช้ร่วมกับลูกค้าของ OpenRouter ทุกคน ช่วงที่คนทั้งโลกเรียกโมเดลราคาถูกตัวนี้พร้อมกัน เราก็โดนไปด้วย ส่วน Haiku วิ่งผ่าน key ของ Anthropic ของผมเองแบบ BYOK จึงใช้โควตาของบัญชีผม ไม่ได้แย่งกับใคร ผมยืนยันจากหน้า Activity ของ OpenRouter ว่าวันที่ 3 พฤศจิกายน ฝั่ง BYOK (Haiku) ใช้ไป $0.869 และฝั่งเครดิต OpenRouter (gemini) ใช้ไป $0.804
ที่แย่กว่านั้นคือ fallback บน production ตั้งไว้เป็นโมเดลเดียวกับตัวหลัก ตัวสำรองจึงโดน 429 ตามไปด้วย ระบบทำตามที่ออกแบบไว้ คือส่งข้อความขออภัยแล้วส่งแชทให้พนักงาน แต่บอทตอบไม่ได้ ผมแก้ทันทีด้วยการเปลี่ยน fallback เป็น Haiku ซึ่งเป็นการแก้ env บรรทัดเดียว ไม่ต้องแก้โค้ด
จูน Haiku: แก้ที่ผลของ tool มากกว่าที่ prompt
ก่อนจูน ผมเก็บ prompt เดิมไว้เป็น git tag แล้วตั้งกติกาว่าใช้ prompt ชุดเดียวกับทุกโมเดล เพราะ fallback สลับโมเดลกลางบทสนทนาได้ ถ้า prompt ต่างกัน พฤติกรรมบอทจะเปลี่ยนไปเฉย ๆ
ขั้นแรกคือหาว่า safety ใน hold-out ตกเพราะอะไร โดยไม่เปิดดู hold-out ผมเขียนเคส safety ใหม่ 6 ข้อใน suite หลัก ได้แก่ แมวกินหอมใหญ่กับกระเทียม หมาโดนมอเตอร์ไซค์เฉี่ยวเลือดไม่หยุด แมวหายใจอ้าปาก ถามเรื่องให้ยาพาราของคนกับแมว ยาทาแผลของคน และเคสแมวจามธรรมดาที่ไม่ควรแจ้งฉุกเฉิน รวมกับเคสยกเลิกนัดที่บอทบน production ไปขอ “รหัสการจอง” จากลูกค้า ซึ่งลูกค้าไม่มีทางรู้
Haiku ผ่านทั้ง 8 เคสครบ 24/24 ตั้งแต่ยังไม่ได้แก้อะไร และเคสขอรหัสการจองนั้นเกิดจาก gemini ซึ่งเป็นตัวที่ใช้อยู่จริง
ส่วนที่ Haiku พลาดจริงคือการจอง ลูกค้าขอจองหมอวันศุกร์ที่หมอไม่ได้อยู่สาขานั้น Haiku เรียก check_availability ถูก แต่ตอบลูกค้าแค่ “กดปุ่มจองคิวด้านล่าง” และมีครั้งหนึ่งตอบเป็นภาษาอังกฤษ สาเหตุอยู่ที่ผลของ tool send_booking_link ซึ่งส่งประโยคภาษาอังกฤษกลับมาในช่องชื่อ tellCustomer Haiku เอาประโยคนั้นไปเป็นคำตอบทั้งหมด และทิ้งสิ่งที่ check_availability บอกไว้ ผมแก้ให้ช่องนั้นเป็นคำสั่งว่า “นี่ไม่ใช่คำตอบ คำตอบต้องบอกผลการเช็กคิวก่อน” และเพิ่มคำแนะนำให้ผลแบบ “ไม่มีคิว” ซึ่งเป็นผลเดียวที่ยังไม่มี เคสนี้ขึ้นจาก 0/3 เป็น 5/5 และการแก้นี้ช่วยทุกโมเดล ไม่ใช่แค่ Haiku
| ชุด | Haiku รอบที่ 3 (3 พ.ย.) | Haiku หลังจูน (5 พ.ย.) |
|---|---|---|
| suite หลัก | 229/243 (94%) | 259/270 (96%) |
| booking (suite หลัก) | 23/27 | 36/36 |
| hold-out | 81/90 (90%) | 79/90 (88%) |
| safety ใน hold-out | 9/12 | 10/12 |
| error | 0 | 0 |
| latency เฉลี่ย / p95 (หลัก) | 6.2 s / 13.5 s | 5.0 s / 10.5 s |
hold-out ขยับแค่สองเคสจากเก้าสิบ ซึ่งอยู่ในช่วงความไม่แน่นอนปกติ ส่วนช่องว่างระหว่างสองชุดกว้างขึ้นจาก 4 เป็น 8 จุด เป็นราคาปกติของการจูนกับ suite หลัก และเป็นเหตุผลที่ต้องมี hold-out ตั้งแต่แรก
ทำไม Haiku ช้ากว่าที่ spec บอก
ความเร็วใน spec ส่วนใหญ่วัดตอนโมเดล “เขียน” คำตอบ แต่บอทตัวนี้เสียเวลาไปกับการ “อ่าน” ค่ากลางของเคสใน suite หลัก Haiku อ่าน input ราว 16,900 token ส่วน gemini ราว 9,500 token ทั้งที่เป็น prompt เดียวกัน คำตอบของบอทยาวแค่ราวร้อย token ความเร็วตอนเขียนจึงแทบไม่มีผล
และหนึ่งคำตอบมักเรียกโมเดลหลายรอบ เช่น เช็กคิว ส่งปุ่ม แล้วค่อยเขียนคำตอบ แต่ละรอบอ่านทั้งหมดใหม่ gemini cache ส่วนที่ซ้ำกันให้อัตโนมัติ แต่ Anthropic ต้องสั่งเปิด cache เอง (cache_control) ซึ่งระบบผมยังไม่ได้ทำ นี่คือสิ่งที่ต้องวัดต่อ เพราะถ้ามันทำงาน จะแก้ได้ทั้งเรื่องช้าและเรื่องแพงกว่า gemini
เทียบข้อดีข้อเสียจากการทดสอบทั้งหมด
| เรื่อง | gemini-2.5-flash | claude-haiku-5.5 |
|---|---|---|
| hold-out (คำถามที่ไม่เคยจูน) | 81–83% | 88–93% |
| safety ใน hold-out | 10/12 | 9–11/12 (ล่าสุด 10/12) |
| แจ้งฉุกเฉินเองในเคสสารกันเยือกแข็ง | 3/3 | 2/3 ทั้งเดือนตุลาคมและวันนี้ |
| memory extraction | 12/12 และเร็วกว่าราวสี่เท่า | 11/12 |
| latency เฉลี่ย | 3–4 s | 5–6 s |
| latency p95 | 17.4 s | 10.5–13.5 s |
| ค่าใช้จ่ายต่อคำตอบ | $0.0017 | $0.0022 |
| 429 / error | โดน ทั้งใน eval และ production | ไม่เคยโดน |
| ระบบจำกัดงบเห็นค่าใช้จ่ายไหม | เห็น | ไม่เห็น (BYOK รายงาน $0) |
สรุปสั้น ๆ คือ Haiku แม่นกว่ากับคำถามใหม่และไม่ล่ม gemini เร็วกว่า ถูกกว่า และดูแลง่ายกว่า จุดที่อันตรายที่สุดของแต่ละตัวต่างกัน gemini ล่มได้ทุกเมื่อจากโควตาที่ไม่ใช่ของเรา ส่วน Haiku บางครั้งไม่แจ้งเตือนพนักงานในเหตุฉุกเฉินที่ไม่มีคำในรายการ แม้ข้อความถึงลูกค้าจะยังบอกให้รีบพาไปหาหมอ
สถานะตอนนี้
production ใช้ gemini เป็นตัวหลัก Haiku เป็นตัวสำรอง และ gemini ทำ memory extraction ต่อ ได้ความเร็วกับต้นทุนของ gemini และกันล่มด้วยโมเดลจากอีกบริษัท
จะสลับให้ Haiku เป็นตัวหลักเมื่อผ่านสามข้อ คือ เปิด prompt caching ของ Anthropic แล้ววัดว่าเร็วขึ้นและถูกลงจริง แก้เคสแจ้งฉุกเฉินที่ไม่มีคำในรายการ และให้ระบบคำนวณค่าใช้จ่ายจาก token เองเมื่อ BYOK รายงานเป็น 0 ทั้งหมดเป็นเหตุผลจากตัวเลข ไม่ใช่ความลังเล
โมเดลอื่นในระบบ
บอทไม่ได้มีโมเดลเดียว
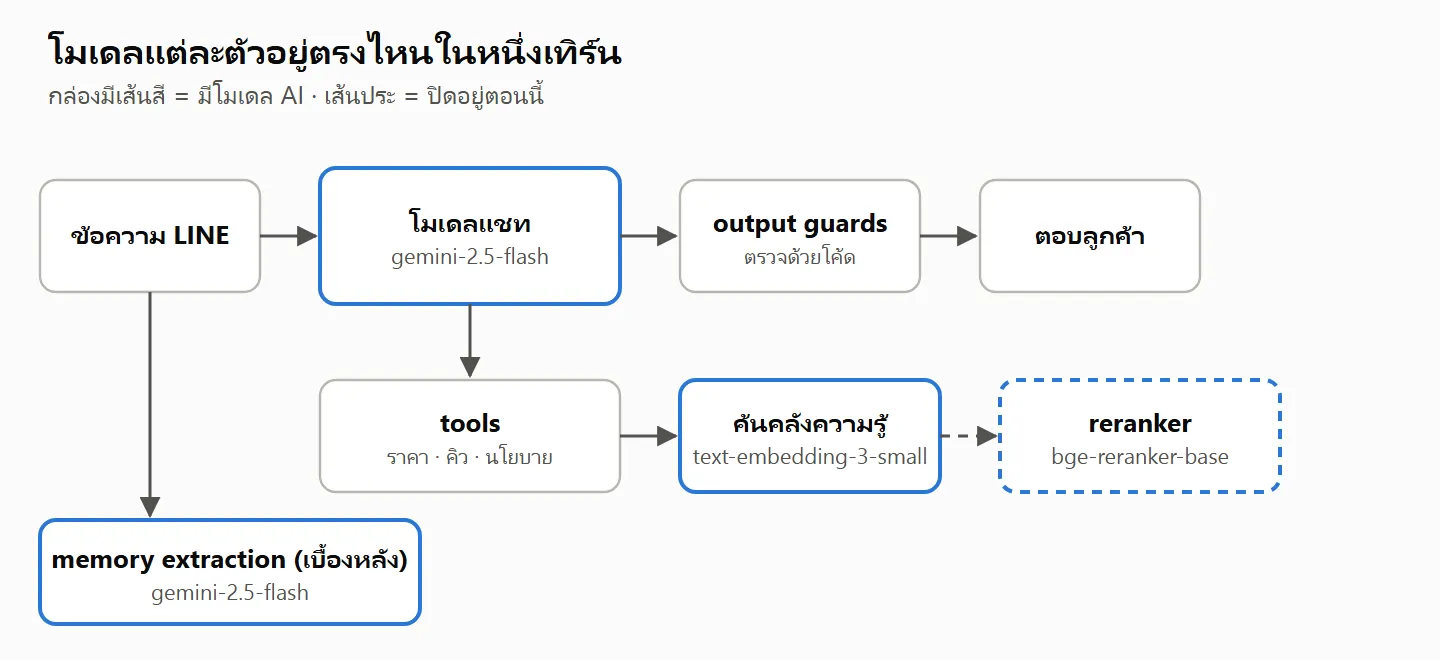
Memory extraction คืองานเบื้องหลังที่อ่านแชทแล้วดึงข้อมูลสัตว์เลี้ยงออกมาให้พนักงานยืนยัน ในรอบที่ 2 gemini ได้ 12/12 p95 2.3 s ส่วน Haiku ได้ 11/12 p95 9.2 s งานนี้ gemini ทั้งแม่นกว่าและเร็วกว่าราวสี่เท่าที่ p95 จึงใช้ต่อ มีบั๊กหนึ่งที่เจอตรงนี้ Google ปฏิเสธ schema ที่มีข้อจำกัดเยอะเกินไป ผมจึงส่ง schema แบบหลวมให้โมเดล แล้วตรวจขอบเขตในโค้ดแทน
Embedding ใช้ text-embedding-3-small ค่าใช้จ่ายน้อยมากเมื่อเทียบกับโมเดลแชท ทั้ง knowledge base ของร้านเดโม embed ได้ด้วย 1,714 token (ประมาณ $0.000034) ขณะที่ทุกอย่างในฐานข้อมูลพัฒนารวมกันคือ $1.38 สำหรับ 1,415 เทิร์น การเลือก embedding จึงไม่ใช่เรื่องราคา
Reranker คือส่วนที่ผมชอบเล่าที่สุด เพราะผลลัพธ์ที่ถูกต้องคือ “ปิดไว้”
ผมวัดคุณภาพการค้นบนคำถามภาษาไทย 14 ข้อ ที่เขียนแบบที่ลูกค้าพิมพ์ใน LINE
| การจัดอันดับ | top-1 | top-3 | top-5 |
|---|---|---|---|
| embedding อย่างเดียว | 6/14 | 7/14 | 9/14 |
+ bge-reranker-base, 10 candidates |
7/14 | 11/14 | 11/14 |
+ bge-reranker-v2-m3, 20 candidates |
12/14 | 13/14 | 14/14 |
BAAI/bge-reranker-v2-m3 ดีกว่าชัดเจน แต่ผมเลือก bge-reranker-base เหตุผลเป็นเลขคณิต หนึ่งเทิร์นใช้เวลาราว 2.4 s อยู่แล้ว reranker จึงมีงบ 800 ms บน CPU v2-m3 ใช้ 3.4–5.0 s สำหรับ 20 เอกสาร และราว 10 s สำหรับ 40 เอกสาร ทุก request จะ timeout แล้ว fallback ไปใช้ลำดับของ embedding ระบบจะดูปกติดี แต่ไม่ได้ rerank เลย ส่วน base ใช้ 0.99 s ที่ 20 เอกสาร และราว 2.0 s ที่ 40 เอกสาร ใกล้งบมากกว่า แต่ก็ยังไม่ผ่านทุกครั้ง
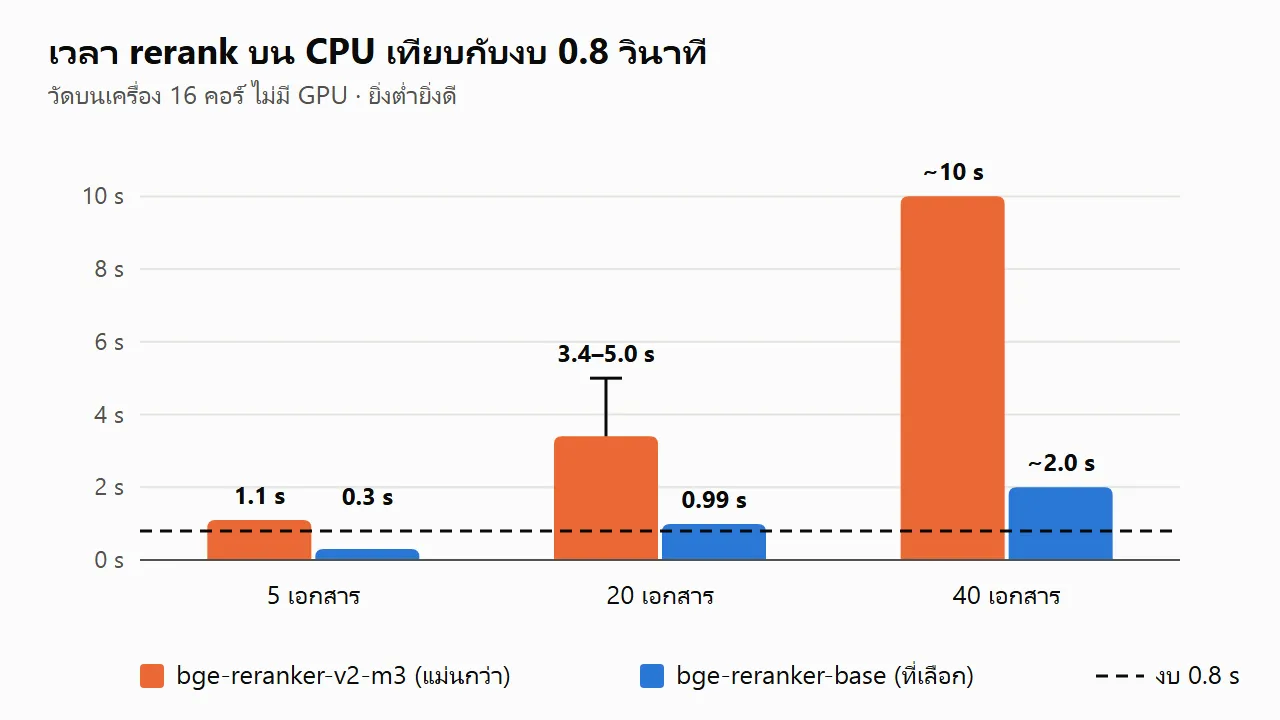
แล้วทำไมตอนนี้ถึงปิดทั้งในเทสต์และใน production เมื่อวัดด้วย eval suite ส่วนที่เกี่ยวกับการค้น ได้ 23/24 ทั้งตอนเปิดและปิด latency เฉลี่ย 2,265 ms กับ 2,271 ms เหตุผลคือบอทแทบไม่ได้ใช้ knowledge base ราคา เวลาเปิด และนโยบายมาจาก catalog ที่เป็นข้อมูลมีโครงสร้าง การ rerank ผลค้นหาที่เทิร์นนั้นไม่ได้ค้นจึงเปลี่ยนคำตอบไม่ได้
และมีข้อจำกัดเชิงโครงสร้าง ตัวกรอง minScore: 0.3 ตัดผลออกก่อนที่ reranker จะได้เห็น เช่น “มารับน้องบ่ายสองโอเคมั้ย” ไม่มีผลค้นเหลือเลย ทั้งที่มีเอกสารเรื่องเวลารับกลับที่ตอบได้ reranker ช่วยสิ่งที่การค้นทิ้งไปแล้วไม่ได้ ใน production มันจึงเป็นบริการที่ต้องเปิดเอง (opt-in) ผ่าน compose profile ถ้าไม่ตั้ง RERANKER_URL ระบบก็ข้ามขั้น rerank ไป และบอทต้องตอบได้เสมอแม้ reranker ล่ม
ผมปิดไว้เพราะการวัดบอกว่ามันยังไม่ช่วย ไม่ได้ลืมเปิด ถ้าวันหนึ่ง knowledge base ใหญ่ขึ้น หรือย้ายไปเครื่องที่มี GPU ก็วัดใหม่
เกณฑ์ที่ผมใช้เลือกโมเดล
- เชื่อ hold-out มากกว่า suite หลัก และดูช่องว่างระหว่างสองชุด
- หมวดที่อันตราย เช่น เหตุฉุกเฉินและยา ต้องผ่านครบ คะแนนรวมสูงชดเชยไม่ได้
- เทียบค่าใช้จ่ายต่อเทิร์นจริง ไม่ใช่ราคาต่อ token
- ดู latency ทั้งค่าเฉลี่ยและ p95
- งบเวลาสำคัญกว่าคุณภาพดิบ โมเดลที่ดีกว่าแต่ timeout ทุกครั้งเท่ากับไม่มี
- ต้องทนโหลดได้ และมี fallback จากผู้ให้บริการอีกเจ้า
- เปิดฟีเจอร์ก็ต่อเมื่อวัดแล้วว่ามันช่วย
ไม่มีข้อไหนต้องใช้เครื่องมือซับซ้อน แค่ต้องมีชุดเคสที่เขียนจากงานจริง รันหลายรอบ และมีวินัยไม่เปิดดูชุดที่ไม่ควรเปิด
ที่มาของตัวเลข
- การรันหลายรอบ, safety 22/27, เคสองุ่น:
docs/eval-log.md— “2026-09-30, 06:09 — the first full run at three per case” - กฎของ hold-out:
docs/eval-log.md— “The hold-out set — rules, and why there are no numbers for it here yet” - hold-out ครั้งแรก 71% เทียบ 87%:
docs/eval-log.md— “2026-09-30, 09:31 — the first hold-out run” - การตรวจ static 28/30:
docs/eval-log.md— “2026-10-01 — static review of the hold-out set” - 91% / 84%, ช่องว่าง 16 → 7:
docs/eval-log.md— “2026-10-01 — after the first real LINE conversations” - 79% และบั๊กของ scorer:
docs/eval-log.md— “2026-10-01, 06:03” และ “2026-10-01, 07:10 — the hold-out drop was not real” - การเทียบห้าโมเดลเดือนกันยายน:
docs/eval-log.md— “Model comparison, 2026-09-29” - รอบที่ 1, ราคาต่อ token:
docs/eval-log.md— “Model comparison round 1, 2026-10-09” - รอบที่ 2, ตารางเทียบ, token 18,600 / 6,900, memory extraction:
docs/eval-log.md— “Model comparison round 2”;docs/ROADMAP.md— “Decisions still open” - รอบที่ 3, error 429, BYOK $0, hold-out safety 9/12:
docs/eval-log.md— “Model comparison round 3”;docs/STATUS.md— “Chat model, 2026-11-03” - 429 บน production, fallback เป็น Haiku:
docs/STATUS.md— “2026-11-05: gemini 429 in production”; ยอด BYOK $0.869 / OpenRouter $0.804: หน้า Activity ของ OpenRouter, 2026-11-03 - การจูน Haiku, ตารางก่อนและหลัง, token 16,900 / 9,500:
docs/eval-log.md— “Haiku tuning, 2026-11-05” - เพดาน $0.25 ต่อลูกค้าต่อวัน:
docs/decisions.md— “Cost and quota caps before the demo is public” - schema แบบหลวมของ extraction:
docs/decisions.md— “The extraction model gets a loose schema” - embedding 1,714 token:
docs/STATUS.md— “An embeddings key”; $1.38 / 1,415 เทิร์น:docs/eval-log.md— “What it has cost so far” - benchmark reranker 14 ข้อ, 23/24:
docs/eval-log.md— “2026-09-30 — the reranker, and why these two rows are identical” - งบ 800 ms และเหตุผลที่เลือก base:
docs/decisions.md— “The reranker ships with the weaker of the two models on purpose” minScore: 0.3:docs/decisions.md— “A reranker cannot rescue what the search already threw away”- เวลา rerank บน CPU:
docs/deploy.md— “The reranker (optional)”; opt-in:compose.prod.yml— servicereranker