Load test ที่โทษผิดคน
ผมทดสอบระบบแชทบอทบน LINE ยังไง และเจออะไร
Petcare Assistant เป็นผู้ช่วย AI และ CRM บน LINE สำหรับร้านสัตว์เลี้ยง ระบบเป็น multi-tenant คือหลายร้านใช้ฐานข้อมูลเดียวกัน แยกข้อมูลกันด้วย row-level security (RLS) ของ Postgres ส่วนที่รับข้อความมีสามชิ้น web (Next.js) รับ webhook จาก LINE แล้วส่งต่อให้ api (NestJS) ซึ่งเก็บ event ลงฐานข้อมูลแล้วตอบ 200 กลับไปทันที จากนั้น worker (BullMQ บน Redis) จะหยิบข้อความไปให้โมเดลตอบในภายหลัง
ผมทำโปรเจกต์นี้คนเดียว ก่อนจะเอาขึ้นเซิร์ฟเวอร์จริงผมอยากรู้ว่าโค้ดช้าตรงไหน เลยทำ load test รอบแรกบนเครื่องตัวเองเมื่อ 2026-10-08 บทความนี้เล่าว่าทำยังไง ใช้เครื่องมืออะไร ทำไมถึงเลือกแบบนั้น แล้วก็เล่าสิ่งที่เจอ ซึ่งมีสองเรื่องที่ผมเดาผิด
วิธีทดสอบก่อน: ถามคำถามให้ถูกข้อ
ผมแบ่งงานเป็นสองรอบ รอบแรกรันบนเครื่องผม เพื่อหาโค้ดที่ช้าแล้วแก้ รอบสองจะรันสคริปต์ชุดเดียวกันกับสำเนาของ demo บนเซิร์ฟเวอร์จริง เพื่อเอาตัวเลขมากำหนดขนาดเครื่อง ผมเขียนกำกับไว้ในแผนตั้งแต่แรกว่าตัวเลขรอบแรก “ไม่ใช่ตัวเลข capacity” เพราะเครื่องผมแรงกว่าเซิร์ฟเวอร์มาก Docker Desktop ยังมี VM คั่นอีกชั้น และตัวยิงโหลดก็ใช้ CPU เครื่องเดียวกัน รอบแรกตอบได้แค่ว่าโค้ดช้าตรงไหน ส่วนคำถามว่าเครื่องรับได้เท่าไรต้องรอรอบสอง
เครื่องมือ: k6 กับ webhook ที่เซ็นเหมือน LINE
ตัวยิงโหลดคือ k6 สคริปต์อยู่ใน loadtest/ แยกไฟล์ตาม scenario และใช้ไลบรารีกลางร่วมกันใน loadtest/lib/line.js
ระบบนี้รับงานผ่าน webhook ผมจึงต้องยิง request ที่หน้าตาเหมือนที่ LINE ส่งมาจริง ทุก request เป็น text event ที่มี replyToken, webhookEventId และ user id แบบสุ่ม แล้วเซ็นด้วย HMAC-SHA256 ของ body ทั้งก้อนโดยใช้ channel secret แปลงเป็น base64 ใส่ไว้ใน header x-line-signature เป็นวิธีเดียวกับคำสั่ง pnpm line:simulate-webhook ที่ใช้ตอนพัฒนา
ที่ต้องเซ็นจริงก็เพราะ api ตรวจลายเซ็นทุก request ถ้าปิดการตรวจตอนทดสอบ ตัวเลขที่ได้ก็จะไม่มีงานส่วนที่หนักที่สุดของ webhook อยู่ในนั้น (ผลข้างล่างจะเห็นว่างานฝั่ง CPU นี่แหละที่เป็นคอขวด) และในโค้ดมีคอมเมนต์เตือนไว้ว่า body ต้องเซ็นแล้วส่งเป็น string ก้อนเดิม ห้าม serialize ใหม่ระหว่างทาง ไม่อย่างนั้น api จะปฏิเสธแบบเดียวกับที่ LINE จริงโดนปฏิเสธ
ทุก request ใช้ LINE user id ใหม่ เหตุผลคือระบบมี rate limit ต่อแชทไว้กันสแปมโดยตั้งใจ ถ้าทุก request มาจาก user เดียว ผลที่ได้ก็จะเป็นระบบกันสแปมทำงานตามที่ออกแบบ ไม่ได้บอกอะไรเรื่อง capacity เลย พอแยก user กันแล้ว ถ้ามี request ไหนโดนปฏิเสธ ก็ต้องนับว่าเป็นสิ่งที่ต้องไปหาสาเหตุ
ไม่เรียกโมเดลจริง ไม่ส่ง LINE จริง แต่โมเดลปลอมต้องช้าเท่าของจริง
ทุกรันตั้ง LLM_PROVIDER=fake และ LINE_SENDER=fake เพราะผมไม่อยากเสียเงินค่าโมเดลกับข้อความเป็นพันๆ ครั้ง และไม่อยากให้มีข้อความหลุดไปถึง LINE จริง ปัญหาคือโมเดลปลอมตอบกลับทันที ถ้าใช้แบบนั้น worker จะดูเร็วกว่าตอนใช้โมเดลจริงประมาณ 100 เท่า ผมเลยเพิ่ม FAKE_LLM_LATENCY_MS ให้โมเดลปลอม แล้วตั้งไว้ที่ 2,000 ms ใกล้กับเวลาที่วัดได้จากโมเดลจริงใน eval ซึ่งอยู่ราว 2.0–2.7 วินาที
รัน production build ไม่ใช่ dev server
pnpm dev ใช้ไม่ได้ เพราะ Next.js ตอน dev จะ compile หน้าเว็บตอนมี request แรกเข้ามา เวลาที่วัดได้เลยไม่มีความหมาย ผมจึงรัน image ตัวเดียวกับ production ผ่าน loadtest/compose.yml ปัญหาต่อมาคือ production มี guard ที่ไม่ยอมให้รันกับโมเดลปลอมหรือ URL ที่เป็น http://localhost ผมไม่อยากทำให้ guard หลวมลง เลยเพิ่มข้อยกเว้นที่มีชื่อชัดเจนขึ้นมาหนึ่งตัวคือ APP_ENV=loadtest ซึ่งยังบังคับว่า public URL ทุกตัวต้องเป็น localhost ถ้าเผลอตั้งค่านี้บนเซิร์ฟเวอร์จริงที่ใช้ https กับโดเมนจริง process จะไม่ยอมสตาร์ทเลย แทนที่จะผ่อนการตรวจลง
สภาพแวดล้อม: บีบให้เหลือขนาดเซิร์ฟเวอร์
เครื่องผมเป็นโน้ตบุ๊ก Intel Core i5-1340P มี 16 logical CPU, RAM 15.7 GB, Windows กับ Docker 28.0.4 และ k6 v2.2.0 ใน loadtest/compose.yml ผม pin ทุก container ไว้ที่ core 0 กับ 1 (cpuset: "0,1") ให้แย่งกันใช้สอง core เหมือนบน t3.small ส่วน k6 ใช้ core ที่เหลือ และตั้ง memory limit รวมประมาณ 1.9 GB (postgres 512m, redis 64m, web 384m, api 384m, worker 512m) ถ้ามี memory leak หรือ concurrency สูงเกินไป จะได้ชนเพดานที่ตำแหน่งเดียวกับเครื่อง 2 GB ฐานข้อมูล, Redis และพอร์ต (3900/3901) แยกออกมาเป็นของ load test ทั้งหมด ไม่แตะ stack ที่ใช้พัฒนาเลย
วัดอะไรบ้าง และเก็บไว้ที่ไหน
ทุกรันเริ่มด้วย loadtest/scripts/run.sh <scenario> สคริปต์นี้
- เขียน
run.jsonเก็บ commit, พารามิเตอร์ของรัน, สเปกเครื่อง, limit ของ container และ delay ของโมเดลปลอม - reset
pg_stat_statementsก่อนรัน แล้วเก็บ 20 query ที่ใช้เวลารวมมากที่สุดไว้ในslow-queries.txt(extension นี้เปิดเฉพาะใน stack ของ load test) - เรียก
docker statsทุกไม่กี่วินาทีเพื่อเก็บ CPU % กับ memory ของแต่ละ container - ให้ k6 ส่งออก
summary.json(p50/p95/p99, throughput, error) กับ CSV ราย request ซึ่งจะถูกย่อเป็นtimeseries.csvช่วงละ 5 วินาที
ใน S2 เวลาที่สำคัญคือตั้งแต่ webhook เข้ามาจนถึงตอนที่ส่งคำตอบออกไป ผมไม่ได้เพิ่ม instrumentation ใหม่ เพราะฐานข้อมูลเก็บ timestamp ไว้อยู่แล้ว หลังจบรันผม query เอาออกมาเป็น bot-turns.csv ได้เลย ผลทุกรันเก็บไว้ใน loadtest/results/ และเขียนเล่าไว้ใน docs/load-test-results.md ทุกรันมีหัวข้อเดียวกันคือ คำถาม, สิ่งที่คาดไว้, ผล และสิ่งที่ผิดคาด การจดสิ่งที่คาดไว้ก่อนรันทุกครั้งทำให้รู้ได้ทันทีเวลาที่เดาผิด
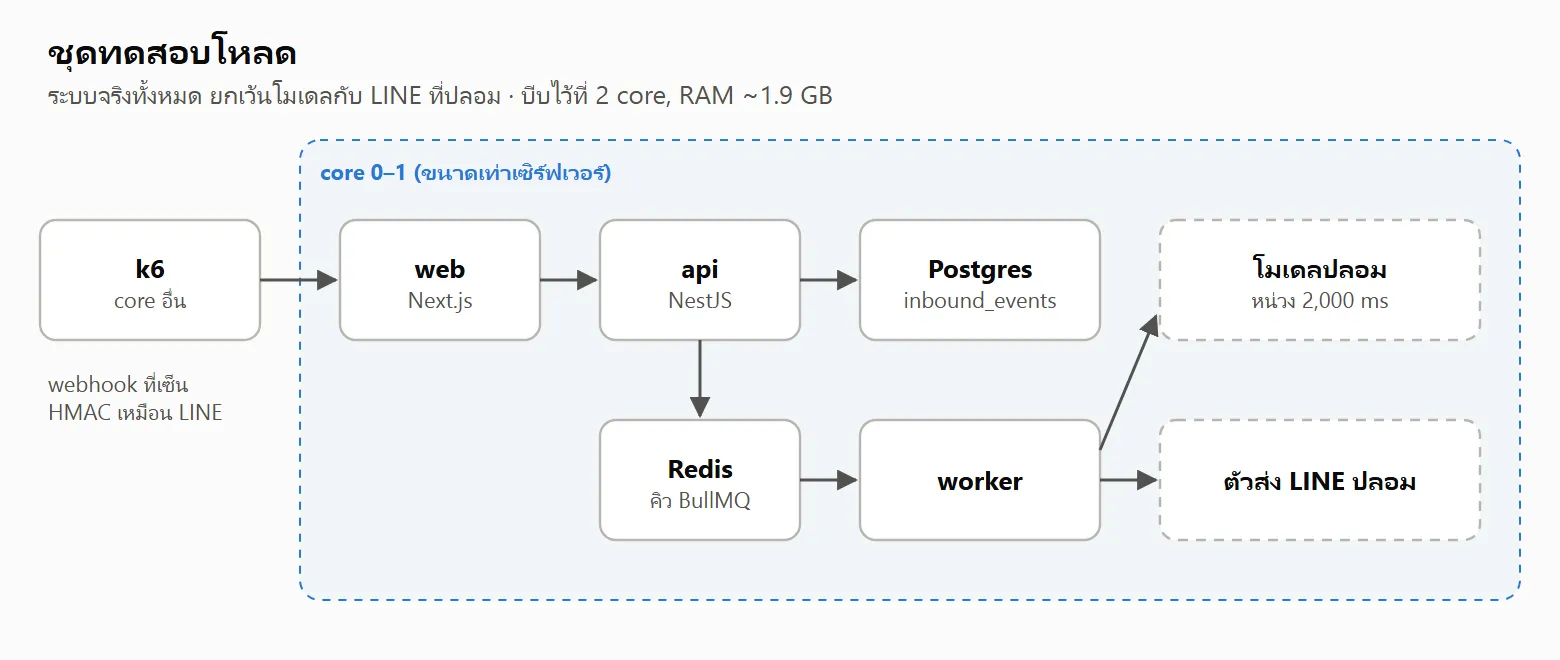
scenario ที่วางไว้ กับที่ทำจริง
ในแผนมีทั้งหมดแปด scenario แต่รอบนี้ทำไปสาม
- S1 webhook burst ยิง webhook ที่เซ็นแล้วด้วย executor แบบ
ramping-arrival-rateไล่จาก 5 → 25 → 50 → 100 request/s แล้วค้างที่ peak ไว้ 30 วินาที รันนี้ปิด worker เพราะอยากวัดแค่ webhook ไม่ให้งานตอบแชทมาแย่ง core (งานนั้นเป็นของ S2) - S2 bot turns ลูกค้าใหม่ส่งข้อความคนละหนึ่งข้อความ ที่อัตรา 0.5, 1, 2 และ 3 แชทต่อวินาที อัตราละหนึ่งนาที รันนี้เปิด worker และใช้โมเดลปลอมหน่วง 2 วินาที
- S8 ประวัติหกเดือน ใส่ข้อมูลย้อนหลังลงฐานข้อมูลแล้วรัน S1 กับ S2 ซ้ำ
ส่วน S3 (หน้าราคา), S4 (คนเปิด dashboard), S5 (inbox stream), S6 (หลาย scenario พร้อมกัน) และ S7 (spike) ยังไม่ได้ทำ API จองคิวก็ตั้งใจไม่ยิงผ่าน HTTP เพราะทุก call ต้องใช้ LINE Login ID token จริง และผมไม่อยากสร้างทางเลี่ยงการตรวจ token ขึ้นมา
เรื่องที่ 1: ผมเดาว่าฐานข้อมูลจะพังก่อน แต่ไม่ใช่
รันแรกของ S1 ใช้โหลดตามแผนคือสูงสุด 100 ข้อความต่อวินาที ได้ 7,425 webhook ไม่มี error เลย median 6.1 ms, p95 10.7 ms, p99 24.4 ms ช่วงที่ช้าที่สุดคือไม่กี่วินาทีแรกที่ process ยังวอร์มไม่เสร็จ ที่ 100/s นี้ api ใช้ CPU ราว 25–30% ของหนึ่ง core, web 10–13%, Postgres 8–10% เป้าที่ตั้งไว้คือ p95 ต่ำกว่า 200 ms
รันที่สองผมดันต่อไปจนกว่าจะพัง ตั้ง -e PEAK=600 ให้ไล่ 150 → 300 → 600 request/s ก่อนรันผมจดไว้ว่า “ฐานข้อมูลน่าจะไม่ไหวก่อน เพราะ webhook ทุกตัวต้องเขียนแถวลงฐานข้อมูล”
ผลคือได้ 34,802 webhook และไม่มี error เลย ช่วงต่ำกว่า ~200 request/s ค่า p95 ยังอยู่ต่ำกว่า 20 ms พอถึงราว 350/s กราฟเริ่มหักโค้ง throughput แบนอยู่ที่ประมาณ 390 request/s ทุก request เริ่มต่อคิว p95 ขึ้นไป ~860 ms และช้าสุด 1.2 วินาที k6 ใช้ virtual user ครบ 300 ตัวแล้วต้องข้าม request ที่วางแผนไว้ 8,872 ครั้ง (k6 ส่งเร็วกว่าที่คำตอบกลับมาไม่ได้) ทำให้ไปไม่ถึง 600/s
ที่ผิดคาดคือตัวที่ตัน ตอนกราฟแบน container ของ api ใช้ CPU ~97–100% ขณะที่ Postgres ใช้แค่ ~35% และ web ~45% ทั้งที่มีให้ใช้สอง core
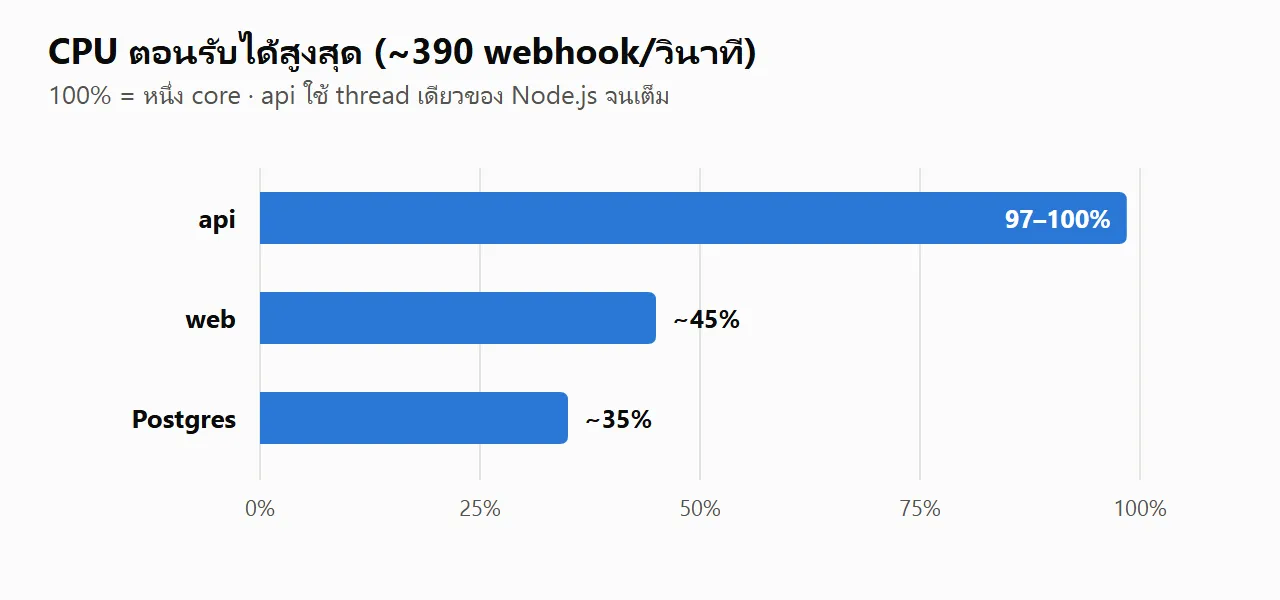
สาเหตุคือ api เป็น Node.js process เดียว และ Node รัน JavaScript บน thread เดียว process หนึ่งจึงใช้ได้อย่างมากหนึ่ง core ไม่ว่าเครื่องจะมีกี่ core ก็ตาม webhook หนึ่งตัวต้อง parse body, ตรวจ HMAC, หา channel แล้ว decrypt credential ก่อนจะบันทึก event รวมแล้วมี 5 query ซึ่ง query ที่ช้าที่สุดคือ insert ใช้เวลาแค่ 0.15 ms ตามที่ pg_stat_statements บอก ที่ทำให้ core เต็มคืองาน CPU ที่อยู่รอบๆ query พวกนั้น ไม่ใช่ตัว query เอง
ผมไม่ได้แก้อะไรจากผลนี้ 390 ข้อความต่อวินาทีมากกว่าที่ LINE OA ของร้านสัตว์เลี้ยงจะได้รับไปไกล ร้านที่ยุ่งมากๆ ก็ได้ข้อความแค่ไม่กี่ข้อความต่อนาที และ LINE ต้องการแค่ให้ตอบ 200 ภายในไม่กี่วินาที ถ้าวันหนึ่งตัวเลขนี้มีความหมายขึ้นมา ทางแก้ก็ชัดอยู่แล้ว คือรัน api สอง process ให้ใช้ core ที่สอง และให้ LINE ส่งตรงไปที่ api ไม่ต้องผ่าน web เพราะในรันนี้ web ใช้ CPU ไป ~45% ของหนึ่ง core แค่กับการส่งต่อ request
เรื่องที่ได้เรียนคือ ก่อนจะ scale ต้องรู้ก่อนว่าคอขวดอยู่ตรงไหน ถ้าผมเชื่อที่เดาไว้แล้วไปซื้อฐานข้อมูลที่ใหญ่ขึ้น ระบบจะไม่เร็วขึ้นเลย แต่ผมก็ต้องจดข้อจำกัดไว้ด้วย รอบนี้ container เขียนลง NVMe SSD ในเครื่องผม ขณะที่ disk แบบ EBS gp3 บนเซิร์ฟเวอร์ช้ากว่า (baseline ราว 3,000 IOPS และทุกการเขียนต้องวิ่งผ่าน network) และ Postgres ต้องรอ disk ทุกครั้งที่ commit บนเซิร์ฟเวอร์จริง ฐานข้อมูลจึงอาจเป็นตัวที่ตันก่อนตามที่เดาไว้แต่แรกก็ได้ เรื่องนี้ต้องรอรอบสองตัดสิน
S2 ไม่มีอะไรผิดคาด ผมคำนวณด้วย Little’s law ไว้ก่อนว่า worker ตอบพร้อมกันได้ 5 turn (RESPOND_CONCURRENCY = 5) และ turn หนึ่งใช้เวลา ~2.5 วินาที ดังนั้นน่าจะรับได้ ~2 แชทต่อวินาที ผลออกมาตรงกับที่คำนวณ ทั้งหมด 391 แชท ไม่มี error ทุกแชทได้คำตอบ ที่ 0.5 และ 1 แชท/s ลูกค้ารอคำตอบ p50 4.8 วินาที (ในนั้นมี 2.5 วินาทีที่ระบบตั้งใจรอให้ลูกค้าพิมพ์จบก่อน และอีก 2 วินาทีเป็นเวลาของโมเดล) ที่ 2/s ค่า p95 ขึ้นเป็น 8.5 วินาที และที่ 3/s ค่า p50 อยู่ที่ 13.5 วินาทีเพราะคิวเริ่มยาว แต่ตอนนั้น worker ใช้ CPU แค่ราว 7–15% มันไม่ได้ทำงานหนัก แค่รอโมเดลอยู่ การเพิ่ม CPU จึงไม่ช่วย ที่ช่วยคือให้รันพร้อมกันได้หลาย turn ขึ้น ซึ่งไปได้จนถึง rate limit ของผู้ให้บริการโมเดล
เรื่องที่ 2: query ที่อ่านข้อมูลหกเดือนเพื่อหาห้าสิบวินาที
ระหว่างอ่าน query ของ S2 ผมเจอสองตัวที่น่าจะช้าลงเรื่อยๆ ตามอายุของร้าน ตัวแรกคือ findFreshReplyToken ซึ่งหา reply token ล่าสุดของลูกค้า เพื่อให้บอทตอบแบบ reply แทน push ที่ต้องนับโควตา ตัวที่สองคือการรวมค่าใช้จ่าย AI ของเดือนนี้ ซึ่งรันทุก turn ตอนฐานข้อมูลยังว่าง ทั้งสองตัวใช้เวลาแค่เศษเสี้ยวมิลลิวินาที ซึ่งบอกอะไรไม่ได้ ผมเลยเพิ่ม S8 เข้าไป
ทำไมต้องหกเดือน และทำไมต้องเป็นข้อมูลสังเคราะห์ ฐานข้อมูลที่เพิ่งสร้างใหม่มีข้อมูลน้อยจนอยู่ใน memory ทั้งหมด index ที่ขาดไปจึงไม่แสดงอาการ loadtest/scripts/seed-history.sql ใส่ข้อมูลให้ร้านหนึ่งร้าน มี 2,000 บทสนทนาที่ปิดแล้ว, inbound event 200,000 แถว และคำตอบที่ส่งแล้ว 200,000 แถว กระจายอยู่ในหกเดือน กับ usage อีก 100,000 แถวในเดือนนี้ (ประมาณ 50,000 turn) รูปร่างของแถวเหมือนที่ pipeline เขียนจริง แต่ไม่มีข้อความของลูกค้าจริงอยู่เลย หลังใส่ข้อมูลแล้วรัน vacuum analyze ให้ตารางอยู่ในสภาพเดียวกับที่ autovacuum ดูแลตารางจริงอยู่
ผลคือ reply-token lookup ช้าขึ้นจาก 0.07 ms เป็น 81 ms ต่อการตอบหนึ่งครั้ง และ budget sum ช้าขึ้นจาก 0.25 ms เป็น 48 ms ต่อ turn ฝั่งลูกค้ารอนานขึ้น 0.13 วินาที (p50 4.81 → 4.94 วินาที) ดูเหมือนน้อย แต่เวลานี้โตเป็นเส้นตรงตามประวัติของร้าน ถ้าข้อมูลมากขึ้นสิบเท่า lookup ตัวเดียวจะใช้เวลาเกือบหนึ่งวินาทีต่อการตอบหนึ่งครั้ง และทั้งหมดคือ CPU ของ Postgres ที่ต้องแบ่งกับงานอื่นบนเครื่องสอง core
เหตุที่ช้าคือ ไม่มี index ที่ตรงกับ query นี้ planner เลยต้องไล่ index (status, received_at) ทั้งก้อน เพื่อหาแถวในช่วงห้าสิบวินาทีล่าสุด ต้นทุนจึงขึ้นกับจำนวนข้อความทั้งหมดที่ร้านเคยได้รับ ไม่ได้ขึ้นกับจำนวนข้อความในนาทีล่าสุด
แก้ทีละขั้น วัดทุกขั้น
ผมแก้ทีละอย่าง และใช้ loadtest/scripts/s8-step.sh <label> วัดทุกขั้นแบบเดียวกัน สคริปต์นี้สร้างฐานข้อมูลใหม่, ใส่ประวัติชุดเดิม, รัน EXPLAIN, รัน S2 ที่ 0.5–2 แชท/s แล้วรัน S1 ที่ไม่เกิน 100/s โดยปิด worker เพื่อดูว่า index แต่ละตัวทำให้การเขียนช้าลงเท่าไร
| ขั้น | เปลี่ยนอะไร | Reply-token lookup | Budget sum |
|---|---|---|---|
| 0 | ยังไม่เปลี่ยน | 80.9 ms | 48.1 ms |
| A | index (channel_id, raw->>'externalUserId', received_at) |
80.6 ms | 48.0 ms |
| B | A + partial index (payload->>'replyToken') where status = 'sent' |
81.7 ms | 47.2 ms |
| B2 | A + index เดียวกันแบบไม่ partial | 81.2 ms | 47.5 ms |
| C | แทน A/B ด้วย inbound (channel_id, received_at), outbound (organization_id, created_at) + เพิ่มเงื่อนไขเวลา |
0.17 ms | 46.4 ms |
| D1 | C + คำนวณวันต้นเดือนแยกไว้ก่อน แล้วส่งเข้าไปเป็น timestamp ธรรมดา | 0.15 ms | 12.3 ms |
| D2 | D1 + ใส่ cost_usd ลงใน index |
0.14 ms | 11.9 ms |
ขั้น A, B และ B2 ไม่ได้เปลี่ยนอะไรเลย ทั้งที่ EXPLAIN ที่ผมรันเองบอกว่า index A ทำให้ lookup ลดจาก 93 ms เหลือ 0.6 ms
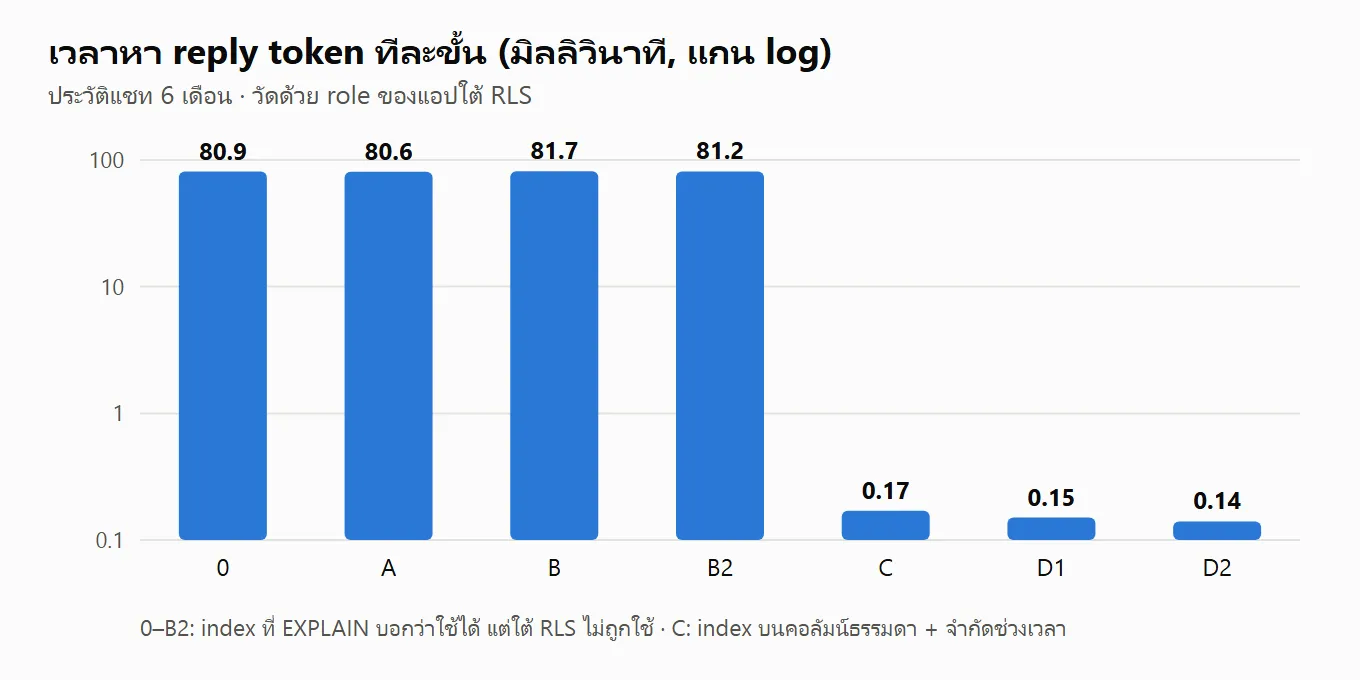
EXPLAIN โกหก เพราะรันผิด role
ผมรัน EXPLAIN ด้วย role ที่เป็นเจ้าของฐานข้อมูล ซึ่งข้าม RLS ไปเลย แต่แอปรันด้วย role petcare_app ที่มี RLS บังคับอยู่ ผมจึงเปิด auto_explain (AUTO_EXPLAIN=1) เพื่อให้ Postgres log plan จริงของทุก statement ที่ช้ากว่า 20 ms ตามที่แอปรันจริง ผลคือไม่มี index ไหนถูกใช้เลย และการเช็กว่า “token นี้ถูกใช้ไปแล้วหรือยัง” ต้องสแกนข้อความที่ส่งแล้วทั้ง 200,000 แถว
อธิบาย RLS กับคำว่า leakproof แบบง่ายๆ คือ ภายใต้ RLS Postgres จะไม่ยอมให้เงื่อนไขใน query ทำงานกับแถวที่ policy ยังไม่ได้ตัดสินว่าผู้ใช้คนนี้มีสิทธิ์เห็นหรือเปล่า เพราะฟังก์ชันอาจทำข้อมูลรั่วออกไปได้ เช่นผ่านข้อความ error ที่แสดงค่าที่มันได้รับ เงื่อนไขจะใช้เป็น index condition ได้ก็ต่อเมื่อ operator และฟังก์ชันทุกตัวในนั้นถูกประกาศว่า leakproof คือรับประกันว่าไม่ทำข้อมูลรั่ว การเทียบค่าแบบเท่ากันหรือมากน้อยบน uuid, text, ตัวเลข และ timestamp เป็น leakproof แต่ ->> (อ่าน field ใน JSON) กับ at time zone ไม่ใช่ index ที่สร้างบน JSON จึงไม่เคยถูกแอปใช้เลย ส่วน partial index ยังมีปัญหาของมันเองอีกเรื่อง คือแอปส่ง 'sent' ไปเป็น bind parameter planner จึงพิสูจน์ไม่ได้ว่าแถวที่ query ต้องการตรงกับ where status = 'sent' ของ index
ทางแก้ (ขั้น C) คือสร้าง index บนคอลัมน์ธรรมดา แล้วเพิ่มเงื่อนไขเวลาให้ query ข้อหนึ่ง คือ outbound_messages.created_at > cutoff เงื่อนไขนี้เป็นจริงเสมอกับ token ที่เพิ่งถูกใช้ไป มันจึงไม่ได้เปลี่ยนผลลัพธ์ แต่ทำให้ index (organization_id, created_at) หาแถวที่เป็นไปได้เจอเพียงไม่กี่แถว ผลคือจาก 81 ms เหลือ 0.17 ms ส่วน budget sum (ขั้น D1) แก้ด้วยการคำนวณ “วันแรกของเดือนตามเขตเวลาของร้าน” แยกไว้ก่อน แล้วส่งเข้า query เป็นค่าธรรมดา ทำให้ลดจาก 48 ms เหลือ 12 ms ลูกค้ารอ p50 เหลือ 4.81 วินาที
ที่เก็บไว้คือ C กับ D1 (migration 0029_reply_token_lookup_indexes) ส่วน A, B และ B2 ทิ้งไปเพราะแอปไม่เคยใช้ D2 ก็ทิ้ง เพราะได้มาแค่ 0.4 ms แต่ต้องเพิ่ม index อีก 1.6 MB ราคาของสอง index ใหม่คือราว 9.7 MB ต่อ 200,000 แถว ตอนแรก S1 หลังขั้น C ดูช้าลง (median 8.2 ms) แต่พอรันซ้ำโดยไม่ rebuild image ก่อน ได้ 5.5 / 10.1 ms เท่ากับ baseline ส่วนต่างนั้นเป็น noise ระหว่างรัน ไม่ได้มาจาก index ข้อนี้ทำให้ผมจดไว้ว่ารอบสองต้องรันซ้ำหลายครั้งก่อนจะเชื่อส่วนต่างเล็กขนาดนี้
กฎที่ได้จากเรื่องนี้ผมจดไว้ใน docs/decisions.md ว่า index สำหรับ query ที่รันภายใต้ RLS ต้องสร้างบนคอลัมน์ธรรมดา ค่าที่ต้องคำนวณให้คำนวณแยกไว้ก่อนแล้วค่อยส่งเข้าไป และถ้าจะ EXPLAIN ก็ต้องรันด้วย role ของแอปพร้อมตั้งค่า tenant ไว้ (explain-growth.sql ตอนนี้ทำแบบนั้นแล้ว)
ขนาด memory
ตัวเลข memory ที่ใช้ตัดสินขนาดเครื่องมาจากการวัดอีกครั้งหนึ่ง (2026-10-03) ใน docs/deploy.md ตอนนั้นยิง webhook ที่เซ็นแล้ว 8 ตัวพร้อมกัน peak ของทั้ง stack ไม่รวม reranker อยู่ที่ 846 MB ถ้ารวม reranker เป็น 1.76 GB เพราะ reranker ใช้ ~900 MB ด้วยตัวเองและไม่เคยลดลง ข้อสรุปคือเครื่อง 2 GB พอสำหรับกรณีไม่มี reranker โดยยังมีที่เหลือให้ OS, Docker และช่วง deploy ที่ process เก่ากับใหม่รันซ้อนกัน (เครื่อง 1 GB จะ swap ทุกครั้งที่ deploy) ถ้าใช้ reranker ต้องเป็น 4 GB ในรัน S2 memory ของ worker ขึ้นจาก ~117 MB เป็น ~215 MB แล้วค้างอยู่ตรงนั้น Node มักไม่คืน memory อยู่แล้ว จึงยังสรุปไม่ได้ว่าเป็น leak ต้องรอ soak test
สิ่งที่ยังไม่ได้ทดสอบ
- S3–S7 ยังไม่ได้ทำ ทั้งหน้าราคา, dashboard, inbox stream, การรันหลาย scenario พร้อมกัน และ spike
- benchmark ของ booking แบบ in-process ที่วางแผนไว้ก็ยังไม่ได้ทำ
- รอบสองบนเซิร์ฟเวอร์จริงยังไม่ได้ทำ ทั้งเรื่อง disk EBS และ CPU credit ของ
t3ที่หมดแล้วเครื่องช้าลง ซึ่งรอบแรกจำลองไม่ได้ - soak test ที่รันโหลดเบาๆ หลายชั่วโมงเพื่อดู memory
- query ของ memory-extraction poller (~340–355 ms รันนาทีละครั้งเบื้องหลัง) ยังไม่ได้แก้
- กราฟ PNG ที่แผนบอกว่าจะสร้างจาก
timeseries.csvยังไม่มี ภาพในบทความนี้ต้องวาดจากตัวเลขในตาราง
checklist สำหรับคนที่จะ load test บอทที่รับงานผ่าน webhook
- ยิง request ที่หน้าตาเหมือนของจริง รวมถึงลายเซ็นด้วย อย่าปิดการตรวจลายเซ็นเพื่อให้ทดสอบง่ายขึ้น เพราะงานส่วนนั้นอาจเป็นคอขวดเสียเอง
- ปลอมโมเดลกับตัวส่งข้อความ แต่ให้โมเดลปลอมช้าเท่าของจริง ไม่อย่างนั้น worker จะดูเร็วเกินจริงหลายสิบเท่า
- วัด webhook กับงานเบื้องหลังแยกกัน (ปิด worker ตอนวัด webhook) และวัดเวลาที่ลูกค้ารอจริงจาก timestamp ในฐานข้อมูล
- รัน production build และจำกัด CPU กับ memory ของ container ให้เท่าเครื่องเป้าหมาย
- ก่อนรันจดไว้ว่าคาดว่าจะเกิดอะไรขึ้น และดู CPU แยกตาม container ตอนกราฟหักโค้ง อย่าเดาว่าอะไรเป็นคอขวด
- ใส่ข้อมูลย้อนหลังหลายเดือนก่อนจะสรุปว่า query เร็ว ฐานข้อมูลที่ว่างเปล่าจะซ่อน index ที่ขาดไป
- ถ้าระบบใช้ RLS ให้ EXPLAIN ด้วย role ของแอป หรือใช้
auto_explainเพื่อดู plan จริงของแอป ไม่ใช่ plan ที่ superuser เห็น
ที่มา
docs/load-test-results.md: Summary, “2026-10-08 — S8, fixing the two queries one step at a time”, “2026-10-08 — S8 months of history, then S2 again (S2 run 2)”, “2026-10-08 — S2 bot turns end to end (run 1)”, “Known limits of round 1”, “2026-10-08 — S1 webhook, to the limit (run 2)”, “2026-10-08 — S1 webhook, the planned load (run 1)”, “How these runs were made”docs/load-test-plan.md: “What exists, and what the numbers will be compared with”, “Rules”, “Two things the harness must solve first”, “Tool”, “Scenarios”, “How the numbers are read”, “Recording every run”docs/decisions.md: “A load test runs the production build on localhost:APP_ENV=loadtest”, “Under row-level security, only leakproof conditions reach an index”docs/deploy.md: “Memory: what the stack uses”docs/portfolio-notes.md: “What was tested”, “What was found and fixed — stories worth telling” (10, 11)docs/STATUS.md(บรรทัด 2026-10-08/09)loadtest/compose.yml,loadtest/loadtest.env,loadtest/lib/line.js,loadtest/scenarios/s1-webhook.js,loadtest/scenarios/s2-bot-turns.jsloadtest/scripts/run.sh,loadtest/scripts/s8-step.sh,loadtest/scripts/seed-history.sql,loadtest/scripts/explain-growth.sqlloadtest/results/2026-10-08-s1-webhook-2/run.json(สเปกเครื่องและเวอร์ชัน k6)